EvalScope 是一个为大模型设计的评测框架,旨在提供简单易用、功能全面的评测流程。本指南将引导您完成从简单到复杂的各类评测任务,帮助您快速上手。
开始第一次评测
您可以通过命令行或 Python 代码两种方式,在指定数据集上使用默认配置评测一个模型。
方式1:使用命令行
在任意路径下执行 evalscope eval 命令即可启动评测。这是最推荐的入门方式。
evalscope eval \
 --model Qwen/Qwen2.5-0.5B-Instruct \
 --datasets gsm8k arc \
 --limit 5
基本参数说明:
方式2:使用 Python 代码
通过调用 run_task 函数并传入 TaskConfig 配置,可以在 Python 环境中运行评测。配置可以是 TaskConfig 对象、Python 字典,或 yaml/json 文件路径。
使用 TaskConfig 对象
from evalscope.run import run_task
from evalscope.config import TaskConfig

task_cfg = TaskConfig(
    model='Qwen/Qwen2.5-0.5B-Instruct',
    datasets=['gsm8k', 'arc'],
    limit=5
)

run_task(task_cfg=task_cfg)
使用 Python 字典
from evalscope.run import run_task

task_cfg = {
    'model': 'Qwen/Qwen2.5-0.5B-Instruct',
    'datasets': ['gsm8k', 'arc'],
    'limit': 5
}

run_task(task_cfg=task_cfg)
使用 YAML 文件
model: Qwen/Qwen2.5-0.5B-Instruct
datasets:
  - gsm8k
  - arc
limit: 5
from evalscope.run import run_task

run_task(task_cfg="config.yaml")
使用 JSON 文件
{
    "model": "Qwen/Qwen2.5-0.5B-Instruct",
    "datasets": ["gsm8k", "arc"],
    "limit": 5
}
from evalscope.run import run_task

run_task(task_cfg="config.json")
查看评测结果
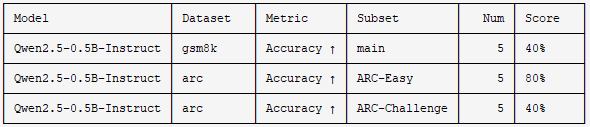
评测完成后,终端会打印出如下格式的得分报告:
小技巧
您还可以通过可视化工具来深入分析评测结果:
pip install 'evalscope[service]'
evalscope service
服务启动后,访问 http://127.0.0.1:9000 即可打开可视化界面。
http://127.0.0.1:9000
进阶用法
评测在线模型 API
EvalScope 支持评测兼容 OpenAI API 格式的模型服务。只需指定服务地址、API Key,并将 eval-type 设置为 openai_api。
示例1:直接评测 OpenAI API 兼容的云端服务(推荐入门方式,无需 GPU)
支持任意 OpenAI API 兼容的模型服务,只需配置 $OPENAI_API_BASE_URL 与 $OPENAI_API_KEY 即可:
evalscope eval \
 --model your-model-name \
 --api-url $OPENAI_API_BASE_URL \
 --api-key $OPENAI_API_KEY \
 --eval-type openai_api \
 --datasets gsm8k \
 --limit 10
示例2:评测自部署的模型服务
以 vLLM 为例,启动一个模型服务:
# 请先安装 vLLM: pip install vllm
export VLLM_USE_MODELSCOPE=True
python -m vllm.entrypoints.openai.api_server \
  --model Qwen/Qwen2.5-0.5B-Instruct \
  --served-model-name qwen2.5 \
  --trust-remote-code \
  --port 8801
使用以下命令评测该 API 服务:
evalscope eval \
 --model qwen2.5 \
 --api-url http://127.0.0.1:8801/v1 \
 --api-key EMPTY \
 --eval-type openai_api \
 --datasets gsm8k \
 --limit 10
如需评测 OpenAI 官方 Responses API,请设置 --eval-type openai_responses_api,并将 --api-url 指向 API 根路径:
evalscope eval \
 --model gpt-4.1-mini \
 --api-url https://api.openai.com/v1 \
 --api-key $OPENAI_API_KEY \
 --eval-type openai_responses_api \
 --datasets gsm8k \
 --limit 10 \
 --generation-config '{"stream": true, "max_tokens": 512}'
自定义评测参数
示例1. 调整模型加载和推理生成参数
您可以通过传入 JSON 格式的字符串来精细化控制模型加载、推理生成和数据集配置。
evalscope eval \
 --model Qwen/Qwen3-0.6B \
 --model-args '{"revision": "master", "precision": "torch.float16", "device_map": "auto"}' \
 --generation-config '{"do_sample":true,"temperature":0.6,"max_tokens":512}' \
 --dataset-args '{"gsm8k": {"few_shot_num": 0, "few_shot_random": false}}' \
 --datasets gsm8k \
 --limit 10
常用参数说明:
示例2. 调整结果聚合方式
对于需要多次生成的任务(如数学题),可以通过 --repeats 参数指定重复生成次数k,并使用 dataset-args 调整结果聚合方式,例如 mean_and_vote_at_k、mean_and_pass_at_k、mean_and_pass^k。
evalscope eval \
 --model Qwen/Qwen2.5-0.5B-Instruct \
 --datasets gsm8k \
 --limit 10 \
 --dataset-args '{"gsm8k": {"aggregation": "mean_and_vote_at_k"}}' \
 --repeats 5
使用裁判模型进行评估
对于某些主观或开放式任务(如 simple_qa),可以指定一个强大的“裁判模型”来评估目标模型的输出。
import os
from evalscope import TaskConfig, run_task

task_cfg = TaskConfig(
    model='qwen2.5-7b-instruct',
    api_url='https://dashscope.aliyuncs.com/compatible-mode/v1',
    api_key=os.getenv('DASHSCOPE_API_KEY'),
    eval_type='openai_api',
    datasets=['chinese_simpleqa'],
    limit=5,
    judge={
        'strategy': 'auto',
        'models': {
            'model_id': 'qwen2.5-72b-instruct',
            'api_url': 'https://dashscope.aliyuncs.com/compatible-mode/v1',
            'api_key': os.getenv('DASHSCOPE_API_KEY'),
        },
    }
)

run_task(task_cfg=task_cfg)
使用 Hugging Face 数据集
EvalScope 默认从 ModelScope 加载数据集。如需改用 Hugging Face Hub,将 --dataset-hub 设置为 huggingface 即可。当某个数据集在 Hugging Face 与 ModelScope 上的仓库 ID 不一致时,再通过 --dataset-args 覆盖该数据集的 dataset_id。
以 ocr_bench 为例,其默认 ID 为 ModelScope 上的 evalscope/OCRBench,对应 Hugging Face 仓库为 echo840/OCRBench:
evalscope eval \
 --model Qwen/Qwen2.5-VL-7B-Instruct \
 --datasets ocr_bench \
 --dataset-hub huggingface \
 --dataset-args '{"ocr_bench": {"dataset_id": "echo840/OCRBench"}}' \
 --limit 5
等价的 Python 写法:
from evalscope import TaskConfig, run_task

task_cfg = TaskConfig(
    model='Qwen/Qwen2.5-VL-7B-Instruct',
    datasets=['ocr_bench'],
    dataset_hub='huggingface',
    dataset_args={
        'ocr_bench': {
            'dataset_id': 'echo840/OCRBench',
        },
    },
    limit=5,
)

run_task(task_cfg=task_cfg)
若数据集在 Hugging Face 与 ModelScope 上的仓库 ID 相同,只需设置 --dataset-hub huggingface,无需再传 dataset_id。
离线评测
在无网络环境下,您可以使用本地缓存的模型和数据集进行评测。
1. 准备本地数据集
数据集默认托管在ModelScope上,加载需要联网。如果是无网络环境,可以使用本地数据集和模型,流程如下:
# 下载数据集
modelscope download --dataset modelscope/MMLU-Pro --local_dir ./data/mmlu_pro
2. 准备本地模型
模型文件托管在ModelScope Hub端,需要联网加载,当需要在离线环境创建评测任务时,可提前将模型下载到本地:
例如使用modelscope命令下载Qwen2.5-0.5B-Instruct模型到本地:
modelscope download --model modelscope/Qwen2.5-0.5B-Instruct --local_dir ./model/qwen2.5
3. 运行离线评测
在评测命令中,将 --model 指向本地模型路径,并通过 --dataset-args 指定数据集的 local_path。
evalscope eval \
 --model ./model/qwen2.5 \
 --datasets mmlu_pro \
 --dataset-args '{"mmlu_pro": {"local_path": "./data/mmlu_pro"}}' \
 --limit 10
从已有/中断的评测结果继续评测
如果之前的评测任务中断,或者您想基于已有的评测结果继续进行评测,可以使用 --use-cache 参数指定之前的输出目录。这将跳过已完成的样本,只评测剩余样本。此外,--rerun-review 会基于缓存的 prediction 重新评分,并只在成功后原子替换 review 缓存。
evalscope eval \
 --model Qwen/Qwen2.5-0.5B-Instruct \
 --datasets gsm8k \
 --limit 10 \
 --use-cache outputs/20230101_123456 \
 --rerun-review
跳过评测出错的样本
在某些情况下,模型可能会因为输入过长、超时、模型服务崩溃等原因导致推理失败,或评测过程中出现了未知错误。这时程序会抛出异常并中断评测流程。您可以通过 --ignore-errors 参数跳过这些出错样本,继续评测剩余样本。在评测报告中,这些样本会被忽略,也就是说最终评测的样本数量会减少。
evalscope eval \
 --model Qwen/Qwen2.5-0.5B-Instruct \
 --datasets gsm8k \
 --limit 10 \
 --ignore-errors
从 v0.1.x 迁移
如果您之前使用的是 v0.1.x 版本,升级到 v1.0+ 后请注意以下主要变化:
本地数据集:不再支持 zip 压缩包格式。请参考离线评测指引,使用 local_path 参数加载本地数据集。
可视化兼容性:v1.0 的输出报告格式已更新,旧版报告与新版可视化工具不兼容。
推理参数:模型推理参数 n 已被移除,请改用 repeats 参数来控制重复生成次数。
评测流程控制:stage 参数已移除。新增 rerun_review 参数,用于在 use_cache=True 时强制重新执行评分步骤。
数据集名称:gpqa 数据集已更名为 gpqa_diamond,且不再需要手动指定 subset_list。
 学习助手