一句话概括核心:当单块 GPU 的显存放不下模型、算力撑不住吞吐时,必须通过并行策略把计算和存储切分到多块 GPU 上协同完成。
前置知识
为什么需要分布式
单卡放不下(Memory Wall)
A100-80G 只有 80 GB 显存。70B 模型仅权重就需要 140 GB,远超单卡容量。即使使用 INT8 量化(70B ~ 70 GB),KV Cache 仍然会溢出。
单卡算不动(Compute Wall)
假设 A100 FP16 Tensor Core 峰值 312 TFLOPS,推理一个 70B 模型单 token 前向推理约需 140 TFLOP(2 × params)。理论最快 0.45 s/token,实际由于 Memory Bound(HBM 带宽 2 TB/s),瓶颈在访存而非计算:
单次 token 生成需读取全部权重 = 140 GBA100 HBM 带宽 = 2 TB/s理论下界 = 140 GB / 2 TB/s = 70 ms实际约 100-200 ms(含 KV Cache 读写、通信开销)
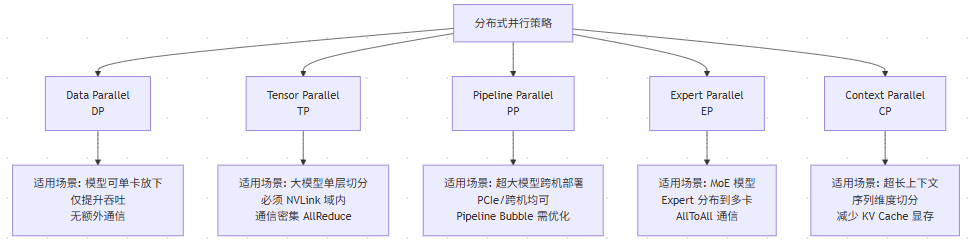
核心概念:四种并行策略
1. Data Parallel(DP)
2. Tensor Parallel(TP)
3. Pipeline Parallel(PP)
4. Expert Parallel(EP)
5. Context Parallel(CP)
通信开销对比
AllReduce 详解 (以 Ring AllReduce 为例):
Send/Recv 详解 (PP 相邻卡通信):
AllToAll 详解 (MoE token 分发):
并行策略组合
实际部署中通常需要多种并行策略组合使用:
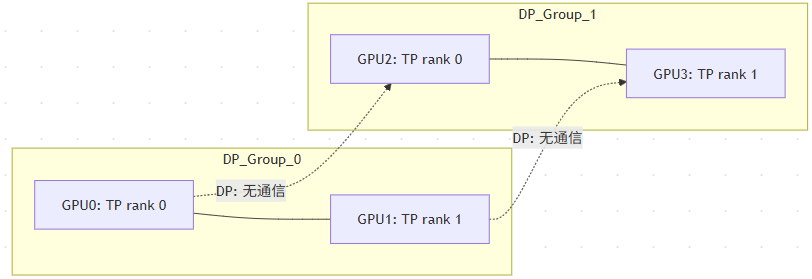
TP + DP(最常见)
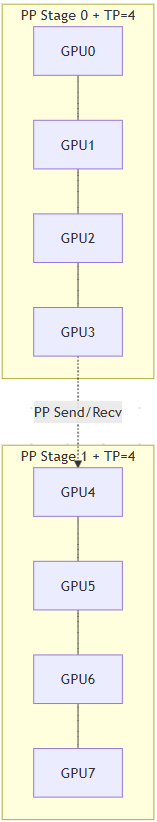
TP + PP + DP(超大模型)
MoE + EP + TP(MoE 模型)
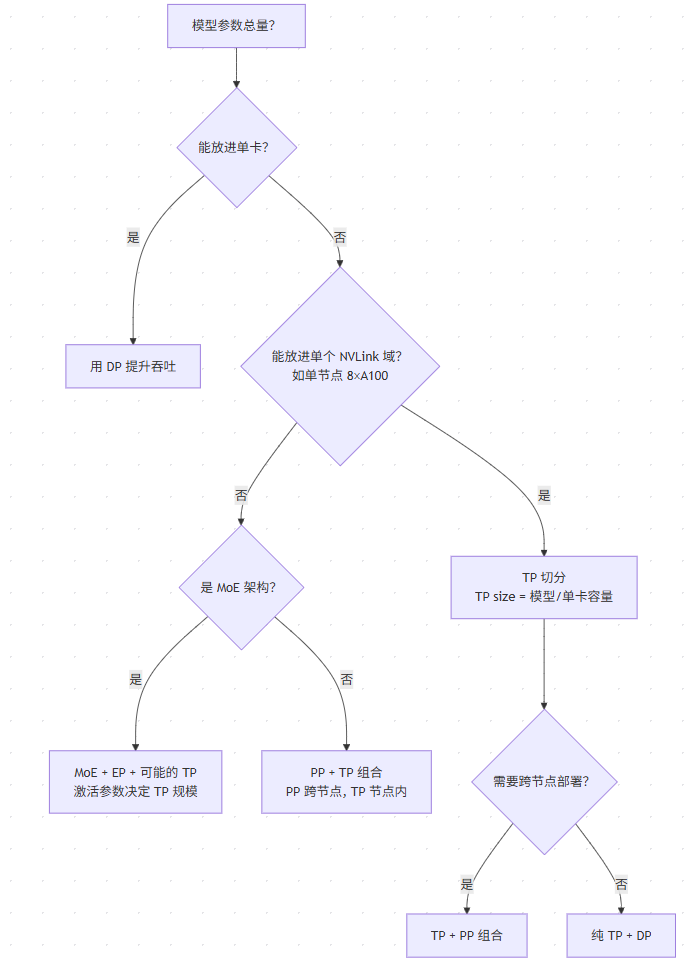
并行策略选择决策树
部署视角
典型配置参考
显存估算公式
单卡显存 ≈ (模型参数 / TP_size) × 2字节 + KV_Cache × batch_size + 激活值 + 通信 bufferKV_Cache ≈ 2 × num_layers × num_heads × head_dim × seq_len × batch × 2字节
面试视角
Q1: 为什么 TP 必须在 NVLink 域内?
核心原因 :TP 需要在每一层的 forward pass 结束时做 AllReduce 同步。以 70B 模型 TP=8 为例:
Q2: DP 和 TP 的本质区别是什么?
Q3: 如何选择 TP size?
经验法则:
Q4: 不同并行策略各自的优缺点和适用场景?
Q5: 实际部署中如何权衡并行策略?
经验法则 :
真实案例 :
 学习助手