KV Cache 占据推理显存的 60-80%,量化 KV Cache 是提升吞吐和并发量的最有效手段之一
前置知识
核心概念(含 Mermaid 图)
为什么 KV Cache 值得量化
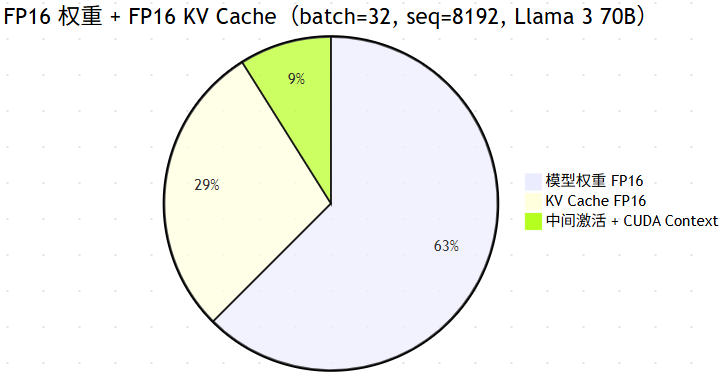
在 LLM 推理中,GPU 显存主要消耗在三个部分: 模型权重 、 KV Cache 、 中间激活值 。其中 KV Cache 在长上下文和大批量场景下占比最大。
关键数据 :
观察: batch=1 短序列:KV Cache 很小,量化收益不大 batch 大 + 长序列:KV Cache 爆炸式增长,量化收益巨大 高并发长文本服务:KV Cache 是显存瓶颈的根因
KV Cache 量化的独特挑战
KV Cache 量化与权重量化有本质区别:
KV Cache 量化为什么更难:1. KV Cache 是在推理过程中动态生成的 → 无法用校准数据预先统计分布 → 需要在线计算 scale(增加延迟)2. 前几层的 KV 和后几层的 KV 分布差异大 → 浅层 KV 变化剧烈,深层 KV 相对稳定 → 统一量化策略对浅层不公平3. KV Cache 中的异常值模式与权重不同 → 某些 token 的 KV 值极大(通常是特殊 token 或标点) → per-tensor 量化时 scale 被 outlier 撑大4. decode 阶段 KV Cache 读取是 memory-bound 的 → 量化减少了带宽,但如果 dequantize 开销大则抵消收益
主流 KV Cache 量化方案
最简单也最实用的方案:量化策略: - per-tensor 对称 INT8 量化 - 每个 KV head 独立 scale(per-head,而非全局 per-tensor) - scale = max(|KV|) / 127,在线计算精度影响: - MMLU 损失 < 0.3% - 生成质量几乎无感知差异 - 长文本场景(> 8K)可能有轻微退化显存收益: - KV Cache 减半(FP16 → INT8) - batch size 可以翻倍(在相同显存预算下)性能收益: - decode 延迟降低 20-40%(带宽减少主导) - 但需要 online dequantize(INT8 → FP16 给 Attention 计算) - fused dequantize kernel 可以将开销降到 < 5%
H100 上的最佳选择:量化策略: - E4M3 格式(权重用 FP8 时 KV 也用 FP8) - per-tensor 或 per-head scale - H100 Tensor Core 原生支持 FP8 Attention精度影响: - MMLU 损失 < 0.2% - 几乎完全无损显存收益: - KV Cache 减半(FP16 → FP8) - 与 INT8 相同的压缩比性能收益: - FP8 GEMM 原生加速 - 不需要 dequantize(FP8 直接计算) - decode 延迟降低 30-50%
KIVI(2024)的核心观察: KV Cache 中 K 和 V 的量化敏感度不同 → K(Key)对量化更敏感(决定 token 之间的相似度) → V(Value)对量化相对宽容量化策略: - K 用 INT4,V 用 INT2 - per-channel + per-token 量化 - 专门优化的 fused Attention kernel精度影响: - K-INT4 + V-INT2:MMLU 损失 0.5-1.5% - K-INT8 + V-INT4:MMLU 损失 < 0.3% - 全 INT4:MMLU 损失 1-2%显存收益: - 混合 INT4/INT2:KV Cache 压缩到 1/3 - 全 INT4:KV Cache 压缩到 1/2适用场景: - 超长上下文(32K+) - 大批量服务(batch > 64) - 对质量有一定容忍度的场景
PQ 的思路: 将 high-dimensional KV 向量分组 每组用 K-means 聚类出 codebook 只存储 codebook 索引(如 8-bit 索引 = 256 个 cluster)优势: - 压缩比极高(可以达到 10x+) - 不依赖硬件 INT8/FP8 支持劣势: - 需要 online 查找 codebook → 推理延迟增加 - codebook 需要存储在显存中 - 实现复杂,工程化难度大适用场景: - 学术研究 / 极限压缩场景 - 目前生产环境较少使用
量化方案对比汇总
部署视角
KV Cache 量化 vs Weight 量化:先量化谁?
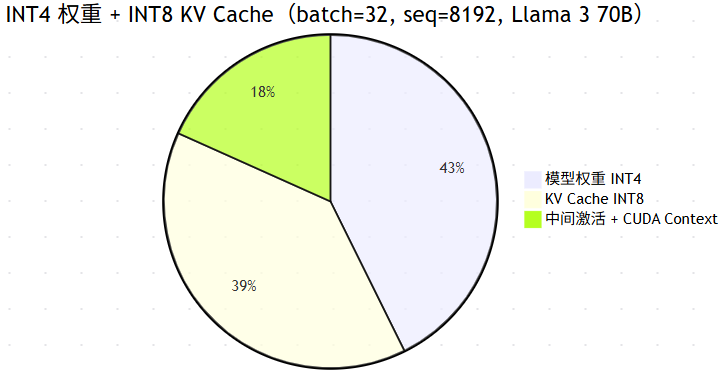
显存优化优先级建议:场景 1:单请求,短序列(batch=1, seq < 4K) 权重占显存主导 → 先量化权重(INT4/AWQ) KV Cache 很小,量化收益不大场景 2:多请求,长序列(batch > 16, seq > 8K) KV Cache 占显存主导 → 先量化 KV Cache(INT8/FP8) 权重量化作为第二步优化场景 3:两者都量化 INT4 权重 + INT8 KV Cache = 最佳性价比 70B 模型:35GB(权重) + 32GB(KV) = 67GB → 1× A100-80G 搞定 FP16 基线:140GB(权重) + 64GB(KV) = 204GB → 需要 3× A100场景 4:极限压缩 INT4 权重 + K-INT4/V-INT2 KV = 35GB + 21GB = 56GB 但质量损失可能 > 2%,需要严格验证
# vLLM INT8 KV Cache 量化配置llm = LLM( model="meta-llama/Llama-3-70B-Instruct-AWQ-INT4", # 权重已量化 quantization="awq", kv_cache_dtype="int8", # KV Cache INT8 量化 gpu_memory_utilization=0.95, # 量化后可以用更高的比例 max_model_len=16384,)# vLLM FP8 KV Cache(H100)llm = LLM( model="...", quantization="fp8", kv_cache_dtype="fp8", gpu_memory_utilization=0.95,)
# vLLM INT8 KV Cache 量化配置
llm = LLM(
model="meta-llama/Llama-3-70B-Instruct-AWQ-INT4", # 权重已量化
quantization="awq",
kv_cache_dtype="int8", # KV Cache INT8 量化
gpu_memory_utilization=0.95, # 量化后可以用更高的比例
max_model_len=16384,
)
# vLLM FP8 KV Cache(H100)
model="...",
quantization="fp8",
kv_cache_dtype="fp8",
gpu_memory_utilization=0.95,
监控 KV Cache 量化效果
关键监控指标:1. KV Cache 显存占比 - 量化前:60-80% - INT8 量化后:30-50% - 目标:降低 30-50 个百分点2. 有效 batch size 提升 - 同样显存预算下,batch size 应提升 1.5-2x - 如果提升不明显,检查是否权重未量化3. 生成质量 - 用 100 条业务数据做 A/B 测试 - 比较量化前后的输出一致性 - 关注:是否有重复生成、乱码、逻辑错误4. 推理延迟 - decode 阶段 per-token 延迟应降低 20-50% - 如果延迟没有降低,检查 dequantize 开销
面试视角
面试官常问问题
Q1: "KV Cache 量化和权重量化有什么区别?为什么 KV Cache 量化更难?"
满分回答要点:
Q2: "KV Cache 量化后,什么情况下精度损失最大?"
Q3: "KV Cache 量化的 trade-off 是什么?怎么决定要不要量化 KV Cache?"
Q4: "量化 KV Cache 会影响推理速度吗?不是说量化后数据变小了应该更快吗?"
最佳实践
调参建议
避坑指南
 学习助手