H100 原生支持 FP8 Tensor Core,在精度损失 < 1% 的前提下实现 1.5-2x 推理加速。
核心概念:浮点数格式对比
Parse error on line 2:...R    subgraph FP32 (32-bit)    A1[1 si
----------------------^
Expecting 'SEMI', 'NEWLINE', 'SPACE', 'EOF', 'GRAPH', 'DIR', 'subgraph', 'SQS', 'end', 'AMP', 'COLON', 'START_LINK',
 'STYLE', 'LINKSTYLE', 'CLASSDEF', 'CLASS', 'CLICK', 'DOWN', 'UP', 'NUM', 'NODE_STRING', 'BRKT', 'MINUS', 'MULT', 'UNICODE_TEXT', got 'PS'
位分配对比
FP8 格式详解
E4M3(推荐用于推理)
E5M2(用于激活值)
E4M3 vs INT8 对比
H100 FP8 Tensor Core
为什么 H100 的 FP8 比 A100 的 FP16 快?
关键原因:
A100 不支持 FP8 Tensor Core,但可以用软件模拟(无加速效果)。FP8 推理需要 H100 或更新架构。
FP8 量化方案
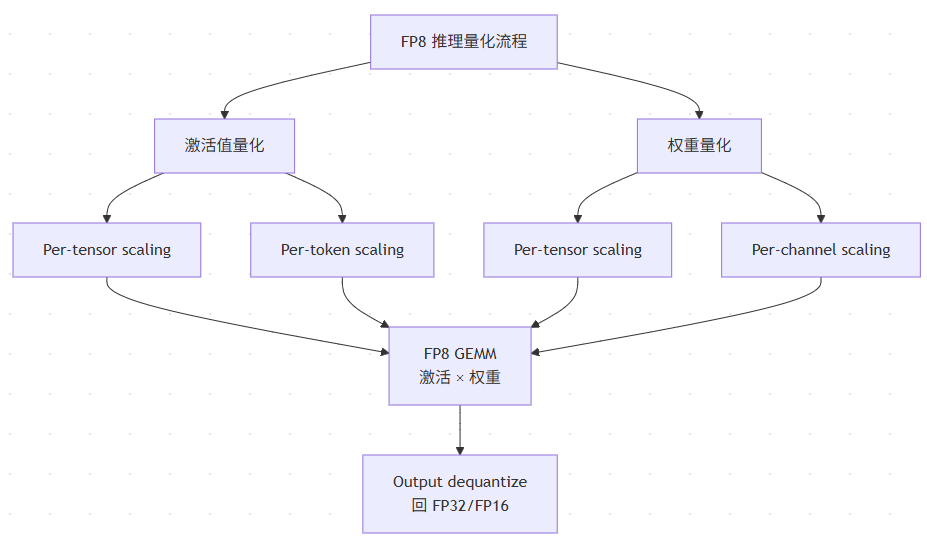
量化策略
Dynamic Scaling(动态缩放)
每层在推理时动态计算缩放因子:
FP8_value = FP32_value / scale_factor其中 scale_factor 通常取该 tensor 的最大绝对值 / 最大可表示值E4M3 最大可表示值 ≈ 448所以 scale = max(|tensor|) / 448
Per-Tensor vs Per-Channel
NVIDIA Transformer Engine 方案
NVIDIA 推荐的 FP8 训练/推理流程:
FP8 推理精度损失分析
不同任务的精度影响
FP8 精度损失通常在 0.5-2pp(percentage points),远低于 INT4(3-5pp)。
哪些层对精度敏感?
Parse error on line 8:
...B3[Attention Scores (softmax 输入)]    C
-----------------------^
Expecting 'SQE', 'DOUBLECIRCLEEND', 'PE', '-)', 'STADIUMEND', 'SUBROUTINEEND', 'PIPE', 'CYLINDEREND',
'DIAMOND_STOP', 'TAGEND', 'TRAPEND', 'INVTRAPEND', 'UNICODE_TEXT', 'TEXT', 'TAGSTART', got 'PS'
FP8 vs INT8:核心优势对比
面试经典问题
面试官:"FP8 相比 INT8 有什么优势?"
关键回答要点:
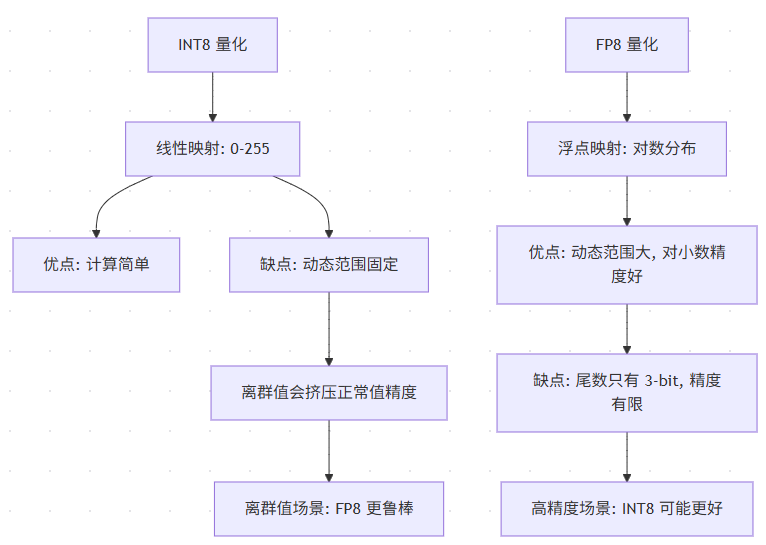
动态范围更大 :FP8 E4M3 范围约 0.0156-512,INT8 范围 -128 到 127
量化方案汇总对比
部署视角
推理框架支持情况
启用 FP8 示例
# vLLM + FP8from vllm import LLMllm = LLM( model="meta-llama/Llama-2-70b", quantization="fp8", # 启用 FP8 量化 dtype="float16", # 计算数据类型)
面试视角
面试官可能问:
"FP8 的 E4M3 和 E5M2 有什么区别?什么时候用哪个?"
"为什么 FP8 适合 LLM 但不适合所有 ML 模型?"
"H100 上 FP8 推理比 FP16 快多少?为什么?"
最佳实践
 学习助手