深入 AWQ、GPTQ、SmoothQuant、FP8 四大主流方案的原理、对比和选型策略
前置知识
核心概念(含 Mermaid 图)
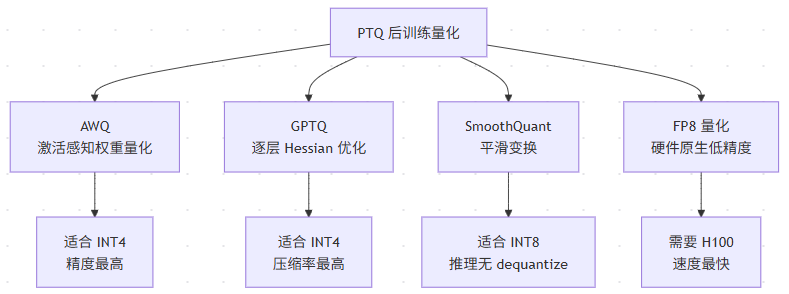
方案全景图
AWQ(Activation-aware Weight Quantization)
核心发现
AWQ(2023,MIT Han Lab)的关键观察是: 并非所有权重都同等重要 。激活值大的 channel 对应的权重如果被量化误差破坏,对最终输出影响远大于激活值小的 channel。
关键洞察:
  在 Linear 层 Y = X @ W 中:
    如果 X 的第 j 列(channel)的 activation 很大
    那么 W 的第 j 行的小误差会被放大到输出 Y
    → 这些权重需要更精细的保护

  传统 INT4 均匀量化:对所有权重一视同仁
  AWQ:放大重要权重、缩小不重要权重后再量化
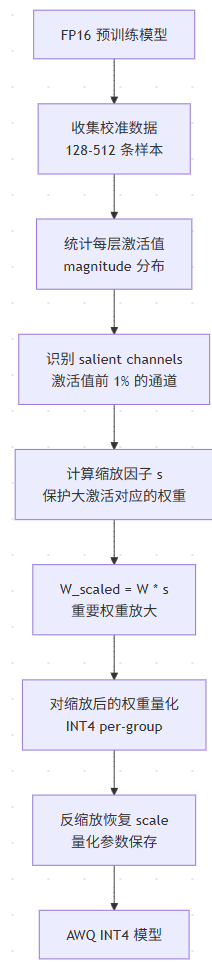
AWQ 流程
为什么 activation-aware 比 uniform 量化好
均匀量化的问题: 假设权重范围 [-3.2, 3.2],INT4 有 16 个离散值,步长 = 0.427 权重 w = 0.21 → 量化为 0,误差 0.21 如果这个 w 对应的 activation = 100,输出误差 = 0.21 * 100 = 21 → 巨大!AWQ 的做法: 检测到大 activation 后,对对应权重乘以 s > 1(放大) 放大后权重范围变大,量化步长相对变小 → 量化误差减小 同时缩小不重要的权重,让它们承受更大的量化误差(反正不影响输出)数学上: Y = X @ W = (X / s) @ (W * s) AWQ 找到最优的 per-channel scaling factor s 最小化量化后输出误差 ||X @ W - Q(X/s) @ Q(W*s)||
权重保护机制
AWQ 只保护 salient weights(约 1% 的权重),其余正常量化:
# 伪代码:AWQ 核心逻辑for layer in model: # 1. 计算激活值 scale act_scale = compute_activation_scale(calib_data) # 2. 找到 salient channels(激活值最大的 1%) salient_mask = act_scale > percentile(act_scale, 99) # 3. 对这些 channel 的权重做缩放 for channel in salient_channels: weight[channel] *= scaling_factor # 量化时这些权重有更大的数值范围 → 更小的相对误差 # 4. 正常量化所有权重 quantized_weight = int4_quantize(weight, group_size=128)
AWQ 的优势与局限
GPTQ(Generative Pretrained Quantization)
核心思想
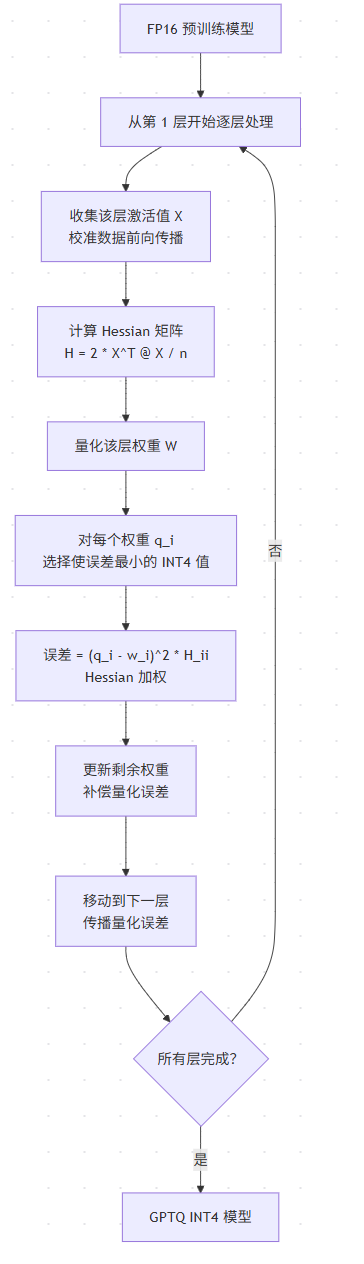
GPTQ(2022)s的核心是 逐层量化 + Hessian 加权误差最小化 。它把量化视为一个优化问题:给定一层 FP16 权重,找到最优的 INT4 近似,使得量化前后该层的输出差异最小。
GPTQ 流程
逐层量化原理
关键创新:不是全局一起量化,而是一层一层来第 t 层: 输入 X_t 已经固定(前面 t-1 层量化完毕) 找到最优的量化 W_t^q 使得: min ||(X_t @ W_t - X_t @ W_t^q)||^2 W_t^q 展开 = (W_t - W_t^q)^T @ (X_t^T @ X_t) @ (W_t - W_t^q) = (W_t - W_t^q)^T @ H @ (W_t - W_t^q) 其中 H = X_t^T @ X_t 就是 Hessian 矩阵的近似
Cholesky 分解与误差回传
GPTQ 的逐列量化策略:1. 对 H 做 Cholesky 分解:H = L @ L^T → 将二次型转化为对角形式,降低优化复杂度2. 逐列(column-wise)贪心量化: for each column j of W: 尝试所有 16 个 INT4 值 选择使 (q_j - w_j)^2 * H_jj + 交叉项误差 最小的值3. 量化误差回传: 量化第 j 列后,产生的误差会影响后续列 更新未量化列的误差累积: W_{:, j+1:} -= (W_{:, j}^q - W_{:, j}) @ H_{j, j+1:} / H_{jj}4. 进入下一层时,输入已经是量化后的输出 → 误差逐层累积,所以第一层的量化精度最关键
GPTQ vs AWQ 对比
SmoothQuant
SmoothQuant(2022,MIT Han Lab)解决的是 激活值 outlier 导致激活量化困难 的问题。它的创新在于:把量化的困难从激活值"平滑"转移给更容易量化的权重。
问题: LLM 激活值中有 extreme outlier(某些 token 的激活值 magnitude 是平均的 10-100 倍) 如果 per-tensor 量化这些 outlier,scale 被撑大 → 正常值的量化粒度变粗 → 精度暴跌 但权重通常没有 outlier,权重量化相对容易SmoothQuant 的方案: Y = X @ W 引入平滑因子 s(per-channel): Y = (X / s^(1/2)) @ (W * s^(1/2)) 效果: X 的 outlier 被除以 s^(1/2) → 激活值范围缩小 → 激活量化变容易 W 乘以 s^(1/2) → 权重范围扩大 → 但权重量化本来就鲁棒,多花一些精度无妨 数学等价:X @ W = (X/s^(1/2)) @ (W*s^(1/2))
per-channel vs per-tensor 量化
per-tensor 量化(传统方法): 整个 tensor 共用一个 scale outlier 撑大 scale → 正常值量化误差大 精度损失:MMLU -3% 以上per-channel 量化(SmoothQuant): 每个输入 channel 独立 scale outlier 只影响自己 channel 的 scale 精度损失:MMLU -0.5% 以内per-token 量化(另一种选择): 每个 token 独立 scale 对 sequence 内分布差异大的情况好 但 inference 时需要动态计算 scale,开销大
SmoothQuant 部署优势
SmoothQuant 的最大卖点:推理时不需要 dequantize传统量化推理流程: 1. 加载 INT8 权重 2. dequantize 到 FP16 3. FP16 GEMM 4. 输出SmoothQuant 推理流程: 1. 激活值 INT8 量化 2. INT8 GEMM(权重已经是 INT8) 3. 输出 → 全程无 dequantize,速度更快这是因为 SmoothQuant 的平滑变换是离线完成的推理时权重直接就是 INT8,激活值也是 INT8
FP8 格式详解
FP8 不是单一格式
FP8 有三种主要变体,区别在于指数位和小数位的分配:
FP8 格式对比:E4M3 (标准 FP8): 1 sign + 4 exponent + 3 mantissa 范围:[-448, 448] 精度:2^3 = 8 级小数精度 适用:权重、激活值通用 NaN 支持:有E4M3nv (NVIDIA 变体): 1 sign + 4 exponent + 3 mantissa 范围:[-240, 240](更小) 特殊:无 NaN,-0 到 +0 的范围映射更密集 适用:NVIDIA 内部优化,TensorRT-LLM 使用E5M2 (IEEE 风格): 1 sign + 5 exponent + 2 mantissa 范围:[-57344, 57344] 精度:2^2 = 4 级小数精度(更粗) 适用:激活值(需要大动态范围) NaN 支持:有
FP8 选择建议
权重量化:E4M3(范围够用,精度高)激活量化:E5M2(outlier 多,需要大范围)KV Cache:E4M3(值分布集中,精度更重要)混合策略:权重 E4M3 + 激活 E5M2 = 最佳 trade-off注意: H100 Tensor Core 原生支持 E4M3 和 E5M2 的矩阵乘 不需要 dequantize → FP8 × FP8 → FP32 accumulate 理论吞吐:FP8 是 FP16 的 2x(H100 上达 3958 TFLOPS)
H100 vs A100 量化支持差异
各方案精度对比
MMLU Benchmark 对比(相对 FP16 的下降幅度)
以下数据综合自原论文和社区验证(Llama 2 7B / 70B 级别模型):
注:g = group_size,越小精度越高但开销越大
推理速度对比(decode 阶段,batch=1,relative to FP16)
部署视角
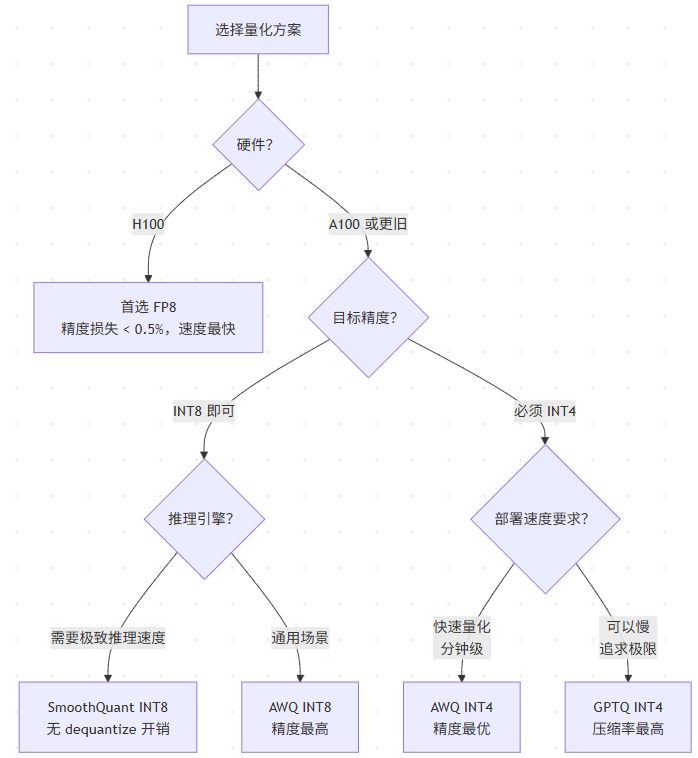
方案选型决策树
各方案生产就绪度
面试视角
面试官常问问题
Q1: "AWQ 和 GPTQ 都是 INT4 量化方案,你选哪个?为什么?"
满分回答要点:
Q2: "SmoothQuant 的 'smooth' 到底 smooth 了什么?为什么有效?"
Q3: "GPTQ 为什么要逐层量化?为什么不一起量化所有层?"
Q4: "FP8 相比 INT8 有什么优势?"
Q5: "FP8 的 E4M3 和 E5M2 怎么选?"
最佳实践
量化参数调优建议
避坑指南
 学习助手