用小模型快速生成 draft tokens,大模型并行验证,在几乎不损失精度的前提下实现 1.5-3x 加速。
核心概念:投机解码原理
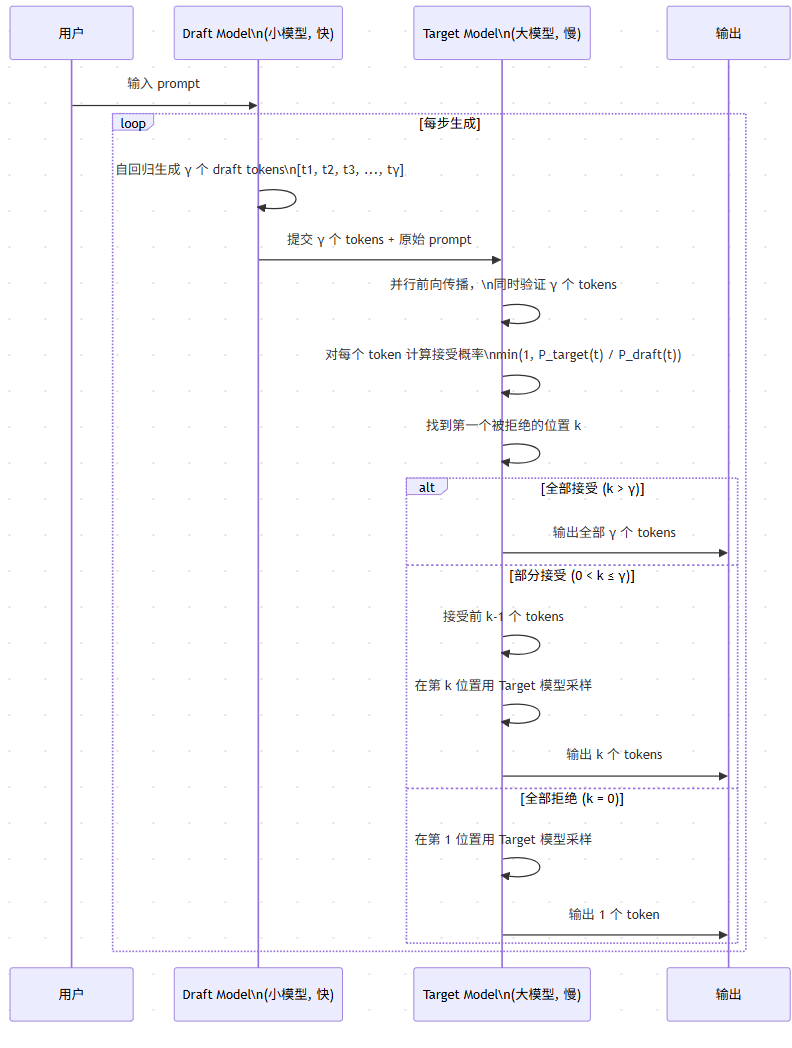
传统自回归解码每次只能生成一个 token,然后要等大模型做一次前向传播才能生成下一个。Speculative Decoding 的核心洞察是: 大模型的前向传播可以并行验证多个候选 token,而不只验证一个 。
算法流程详解
1. Draft 阶段:小模型自回归生成 γ 个候选 tokens - γ 通常为 3-6(太多接受率低,太少加速效果弱) - 小模型可以是:独立小模型 / 同一模型的量化版本 / 训练好的预测头2. Verify 阶段:大模型并行验证所有 γ 个 tokens - 用大模型对 [prompt + draft tokens] 做一次前向传播 - 对每个 draft token t_i,计算接受概率 α_i = min(1, P_target(t_i) / P_draft(t_i)) - 从第一个 token 开始,逐个用随机采样决定是否接受3. 接受/拒绝逻辑 - 如果 t_i 被接受 → 继续检查 t_{i+1} - 如果 t_i 被拒绝 → 停止,在位置 i 用大模型重新采样一个 token - 输出被接受的 tokens + 最多一个新采样 token
关键保证:Speculative Decoding 的采样分布与直接运行大模型完全一致(数学上无损)。
加速比分析
理论加速比
理论加速比 = 1 + γ × 接受率其中: γ = 每次生成的 draft token 数 接受率 = draft token 被 target 接受的概率
实际加速比
实际加速比低于理论值,因为 draft model 也需要计算开销:
实际加速比 = (接受的 draft tokens 数 + 1) / (1 + draft model 开销比)
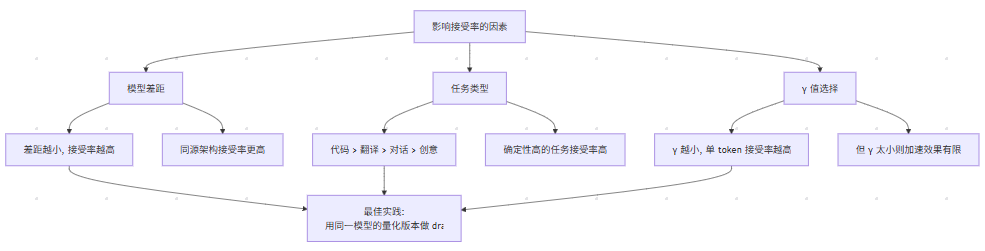
接受率越高,加速效果越好。接受率取决于 draft 和 target 模型的差距。
接受率分析
什么情况下接受率高?
高接受率场景:
低接受率场景:
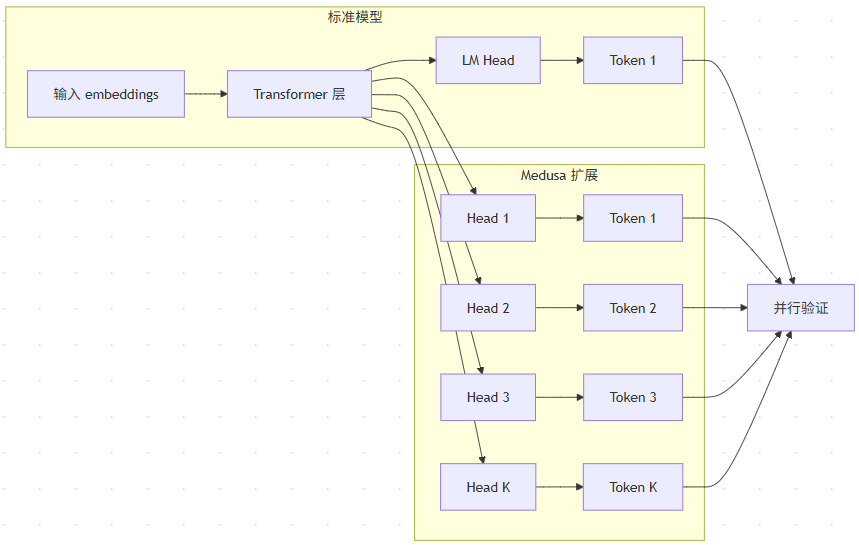
Medusa 方案
Medusa 是 Speculative Decoding 的一个变体, 不需要额外的 draft 模型 。
Medusa vs 标准 Speculative Decoding
Medusa 的优势
部署视角
vLLM 中的 Speculative Decoding
# vLLM 配置示例from vllm import LLMllm = LLM( model="meta-llama/Llama-2-70b", # target model speculative_model="meta-llama/Llama-2-7b", # draft model num_speculative_tokens=4, # γ = 4 use_v2_block_manager=True,)output = llm.generate(prompt, sampling_params)
调优建议
面试视角
面试官可能问:
"Speculative Decoding 为什么能加速?它不会多算一遍吗?"
这是最经典的面试问题。核心回答:
不会。Speculative Decoding 的接受概率 α = min(1, P_target/P_draft) 保证了 输出分布与直接运行大模型完全一致 (通过 rejection sampling 保证)。这是一种 无损加速 。
"什么时候不适合用 Speculative Decoding?"
适用场景和限制
最佳适用场景
不适用场景
与其他技术的兼容性
Speculative Decoding 可与以下技术叠加使用:
  ✅ Continuous Batching:兼容,效果独立
  ✅ PagedAttention:兼容,显存管理无关
  ✅ FP8/INT8 量化:兼容,draft 和 target 可分别量化
  ✅ FlashAttention:兼容,加速预填充阶段

  ⚠️ 多 LoRA:每个请求不同 LoRA 时 draft model 难以匹配
  ❌ 与 Early Exit 互斥:两种方法都试图减少 decode 步数,叠加效果递减
最佳实践
生产环境调优 Checklist
 学习助手