理解 compute-bound vs memory-bound 是推理优化的核心能力,决定了你该优化计算还是优化带宽。
前置知识
核心概念:瓶颈类型判定
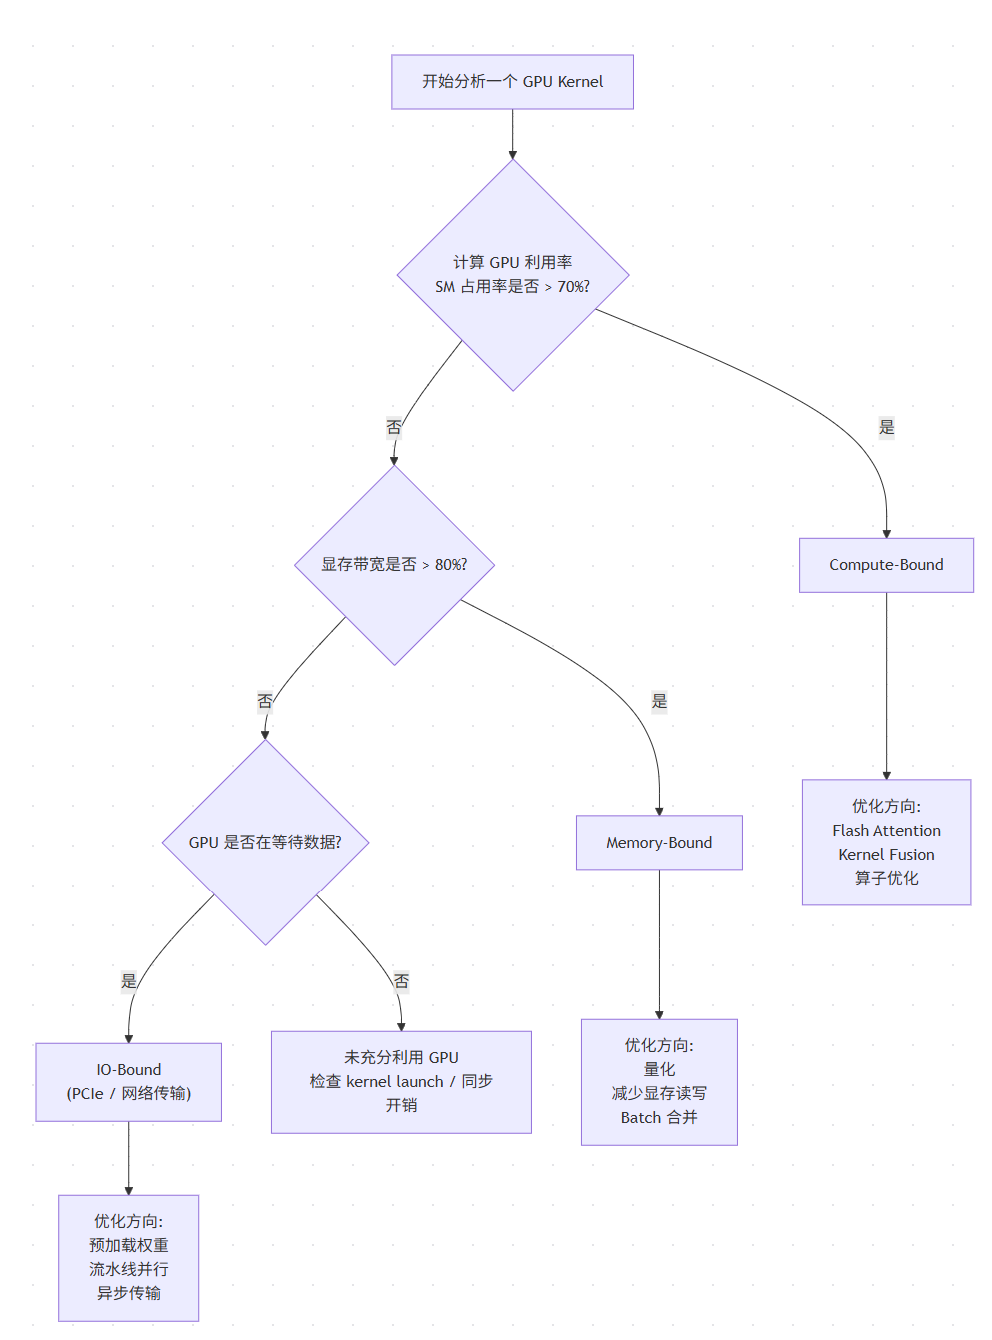
Compute-Bound vs Memory-Bound 判定流程
Roofline Model —— 定量分析工具
Roofline Model 是 Berkeley 提出的可视化性能分析模型,横轴是 计算强度 (FLOPs/Byte),纵轴是 实际性能 (TFLOPS):
    性能 (TFLOPS)
        │
   峰值算力 ───────┐  ← Compute-Bound 区域(平台)
        │        /
        │      /
        │    /  ← Memory-Bound 区域(斜线)
        │  /
        │/
        └──────────────── 计算强度 (FLOPs/Byte)
          ← 低 →  ← 高 →
LLM 推理的两个阶段
Prefill 阶段 —— Compute-Bound
Prefill 是处理用户输入 prompt 的阶段 ,对所有输入 token 做完整的自注意力计算。
为什么是 compute-bound?
Attention 的核心计算是 Q @ K^T ,复杂度为 O(n² × d) ,其中 n = sequence length,d = head dimension:
# Prefill: prompt 长度为 nQ = X @ W_q # (n, d) = (n, h) × (h, d)K = X @ W_k # (n, d) = (n, h) × (h, d)V = X @ W_v # (n, d) = (n, h) × (h, d)scores = Q @ K^T / sqrt(d) # (n, n) = (n, d) × (d, n) ← O(n²) 矩阵乘法!attn = softmax(scores) @ V # (n, d) = (n, n) × (n, d)
当 n 较大时(如 n = 4096), Q @ K^T 的矩阵规模是 4096×4096,FLOPs 为 2 × 4096³ ≈ 137 GFLOPs ,但只需要加载 4096 × d 的数据。计算强度很高,GPU 的 Tensor Core 被充分占用。
优化手段 :
Decode 阶段 —— Memory-Bound
Decode 是逐 token 生成的阶段 ,每次只生成 1 个新 token。
为什么是 memory-bound?
Decode 阶段每次只处理 1 个新 token:
定量计算:70B 模型 decode 阶段的内存带宽需求
假设:
每个 token 生成需要加载 140 GB 权重:
而 H100 SXM 的 HBM 带宽只有 3.35 TB/s = 3,350 GB/s :
如果用 4 卡 TP(张量并行):
结论 :Decode 阶段速度 = 总显存带宽 / 模型权重大小。这是物理定律,无法通过优化算法绕过。
Prefill vs Decode 对比
Profiling 工具实战
nvidia-smi —— 实时监控
# 每秒刷新,查看 GPU 利用率、显存、温度watch -n 1 nvidia-smi# 只监控特定指标nvidia-smi --query-gpu=utilization.gpu,memory.used,memory.total --format=csv -l 1
关键指标:
nvtop —— 交互式监控
# 安装sudo apt install nvtop# 运行nvtop
nvtop 提供实时图表,直观展示 GPU 利用率、显存、编码器使用率的时序变化。
nvidia-nsys —— 系统级 Profiling
NVIDIA Nsight Systems(nsys)是分析 GPU 性能瓶颈的专业工具,能生成详细的时间线报告:
# 对 vLLM 推理做 profilingnsys profile --trace=cuda,nvtx,osrt -o output \ python3 -m vllm.entrypoints.openai.api_server \ --model meta-llama/Llama-3-70B-Instruct# 查看报告nsys stats output.nsys-rep# 生成可视化时间线nsys-ui output.nsys-rep
关键分析维度 :
判断瓶颈的快速方法 :
# nsys 报告中查看# SM throughput 高 + HBM 带宽低 → compute-bound# SM throughput 低 + HBM 带宽高 → memory-bound# 两者都低 → 可能是 IO-bound 或同步开销
PyTorch Profiler
import torch.profilerwith torch.profiler.profile( activities=[torch.profiler.ProfilerActivity.CUDA], profile_memory=True,) as prof: model.generate(input_ids, max_new_tokens=128)# 查看每个 kernel 的时间print(prof.key_averages().table(sort_by="cuda_time_total", row_limit=20))# 导出为 Chrome Trace 可视化prof.export_chrome_trace("trace.json")
面试视角
常考问题
"如何判断一个操作是 compute-bound 还是 memory-bound?"
最佳实践
 学习助手