一句话概括:TensorRT-LLM 是 NVIDIA 官方的 LLM 推理加速库,通过编译时深度优化(kernel fusion、precision calibration)在 NVIDIA GPU 上提供业界最高的推理性能。
前置知识
TRT-LLM vs vLLM 的定位差异
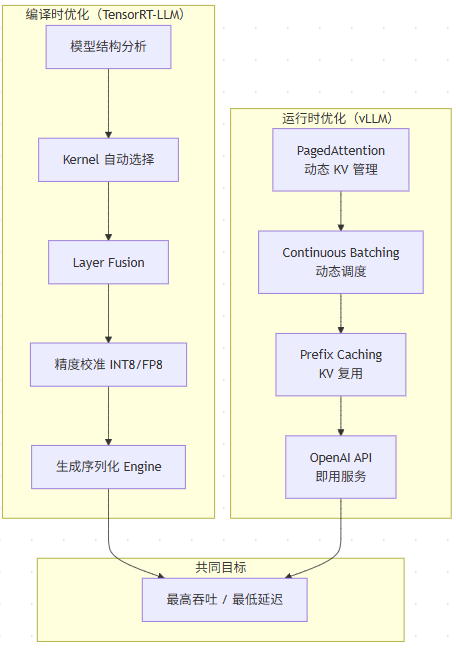
这是面试中经常被问到的问题。理解两者的定位差异是选择的基础:
一句话总结 :TRT-LLM 是 编译器思路 ——花时间在构建阶段找到最优执行方案;vLLM 是 运行时思路 ——在请求处理过程中动态优化资源分配。
TRT-LLM 编译优化管线
构建阶段详解
1. 计算图解析
TRT-LLM 将 PyTorch 模型转换为内部计算图表示,识别每个 layer 的类型(Attention、MLP、Normalization 等)和依赖关系。
2. 算子选择(Kernel Selection / Auto-tuning)
对于每个算子,TRT-LLM 从 kernel 库中选择最优实现。选择依据包括:
对于关键算子(如 GEMM),TRT-LLM 会在构建阶段进行 微基准测试(micro-benchmark) ,测量不同 kernel 配置的实际性能,选择最快的一个。
3. Layer Fusion
将多个连续的小算子合并为一个大 kernel,减少 kernel launch overhead 和中间数据的显存读写。典型融合:
原始计算图:                Fusion 后:
  Input                      Input
    │                          │
  ┌─┴─┐                      ┌─┴──────────┐
  │Add│                      │            │
  └─┬─┘                      │ Fused      │
    │    ┌─────┐             │ Kernel     │
  ┌─┴─┐  │     │             │ (Add+Norm  │
  │Mul│  │Bias │    ──→      │ +Bias+...+ │
  └─┬─┘  │     │             │  GELU)     │
    │    └─────┘             │            │
  ┌─┴──────────┐             └─┬──────────┘
  │LayerNorm   │               │
  └─┬──────────┘             Output
    │
  ┌─┴─┐
  │GELU│
  └────┘
4. 精度校准(INT8 Calibration)
TRT-LLM 使用**校准数据集(calibration dataset)**来自动确定 INT8 量化的缩放因子(scale)和零点(zero point):
相比加载预量化权重,TRT-LLM 的自动校准优势在于:可以对未量化的原始 FP32/BF16 模型直接生成 INT8/FP8 engine。
推理阶段详解
In-flight Batching
与 vLLM 的 Continuous Batching 类似但实现不同:
实际效果上两者相似,但 TRT-LLM 的实现由于是静态计算图,batch 管理的开销更小。
Tensor Parallelism
TRT-LLM 支持动态 Tensor Parallelism:
TRT-LLM 核心特性
Kernel Fusion 详解
TRT-LLM 的 fusion 策略分为几个层次:
Fusion 的收益:
在 A100 上,kernel fusion 可以带来 1.3-1.5x 的加速。
Dynamic Tensor Parallelism
TRT-LLM 支持在运行时调整 TP 策略:
单 GPU (TP=1): [完整模型]双 GPU (TP=2): [模型前半] <--NCCL--> [模型后半]四 GPU (TP=4): [1/4] <--NCCL--> [1/4] <--NCCL--> [1/4] <--NCCL--> [1/4]
关键设计:
TRT-LLM 构建流程
完整构建步骤
Step 1:安装与准备
pip install tensorrt_llm# 或使用 NVIDIA NGC 容器docker pull nvcr.io/nvidia/tritonserver:24.01-trtllm-python-py3
Step 2:构建 Engine
# 以 Llama-3-8B 为例cd /usr/local/binpython build.py \ --model_dir /path/to/Llama-3-8B-Instruct \ --dtype bfloat16 \ --use_inflight_batching \ --world_size 1 \ --tp_size 1 \ --pp_size 1 \ --max_batch_size 256 \ --max_input_len 4096 \ --max_output_len 2048 \ --output_dir ./llama3_trt \ --remove_input_padding
Step 3:序列化与部署
import tensorrt_llmfrom tensorrt_llm.runtime import ModelRunner# 加载 enginerunner = ModelRunner.from_dir( engine_dir="./llama3_trt", rank=0,)# 推理output_ids = runner.generate( input_ids=prompt_ids, max_new_tokens=128, temperature=0.7,)
关键构建参数
支持模型列表
NVIDIA 持续扩展 TRT-LLM 的模型支持范围。截至 2026 年中,主要支持:
注意 :TRT-LLM 的模型支持需要针对每种架构编写优化代码,所以覆盖率不如 vLLM。部署新模型前,先查阅 TRT-LLM 的 GitHub 支持列表 。
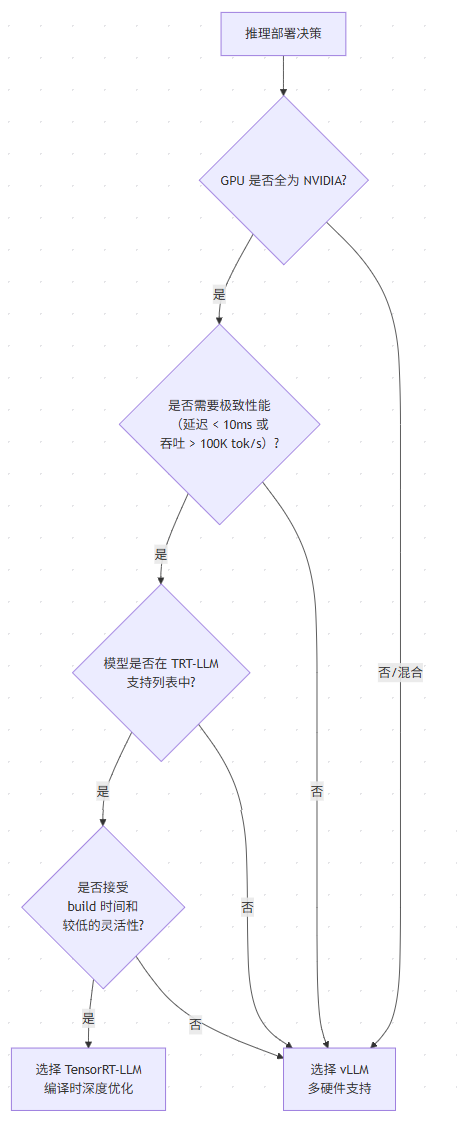
部署场景选择
什么时候用 TRT-LLM 而不是 vLLM?
选择 TRT-LLM 的场景 :
选择 vLLM 的场景 :
面试视角
TRT-LLM 为什么在某些场景下比 vLLM 快?
推荐回答 :
"TRT-LLM 在 NVIDIA GPU 上通常比 vLLM 快 20%-100%,主要原因有三:
编译时 kernel 选择 :TRT-LLM 在构建阶段会对关键算子(如 GEMM)进行 micro-benchmark,为当前 GPU 和输入 shape 选择最快的 kernel 配置。而 vLLM 使用固定的 custom kernel,无法针对具体硬件微调。
更激进的 kernel fusion :TRT-LLM 可以将多个连续的 layer(如 LayerNorm + Linear + GELU)融合为单个 kernel,减少了 kernel launch overhead(在 decode 阶段,每个 step 都要 launch 所有 kernel,launch overhead 占比更高)和中间数据的显存读写。
静态计算图优化 :TRT-LLM 知道完整的计算图,可以进行跨层优化(如常量折叠、算子重排),而 vLLM 的 PyTorch 后端在 eager mode 下只能逐算子执行。
但需要注意的是,这些优势的前提是:模型在 TRT-LLM 支持列表中、build 时间可以接受、不需要频繁切换模型。"
追问:TRT-LLM 的缺点是什么?
什么是 In-flight Batching?和 Continuous Batching 的区别?
两者本质上做的是同一件事——不等整个 batch 完成就动态替换已完成的请求。区别在于实现层次:
实际效果上差异不大,但 TRT-LLM 的 token 级管理在 batch 利用率上略高 5-10%。
TRT-LLM 的 INT8 量化是如何做到无损的?
TRT-LLM 使用**校准(calibration)**方法:
这种方法比训练后量化(PTQ)更精确,因为它考虑了实际的激活分布,而非简单的 min-max 映射。在 Llama-2-7B 上,INT8 量化通常只带来 < 0.5% 的精度损失,但推理速度提升 1.5-2x。
最佳实践
TRT-LLM + Triton Inference Server 部署
NVIDIA 推荐的生产部署方式是将 TRT-LLM 集成到 Triton Inference Server:
Client → Triton Inference Server → TRT-LLM Backend → GPU
优势:
性能优化 checklist
 学习助手