单机多卡靠 NVLink,多机多卡靠 InfiniBand。互联带宽直接决定张量并行(TP)的可行性。
前置知识
核心概念:GPU 互连拓扑
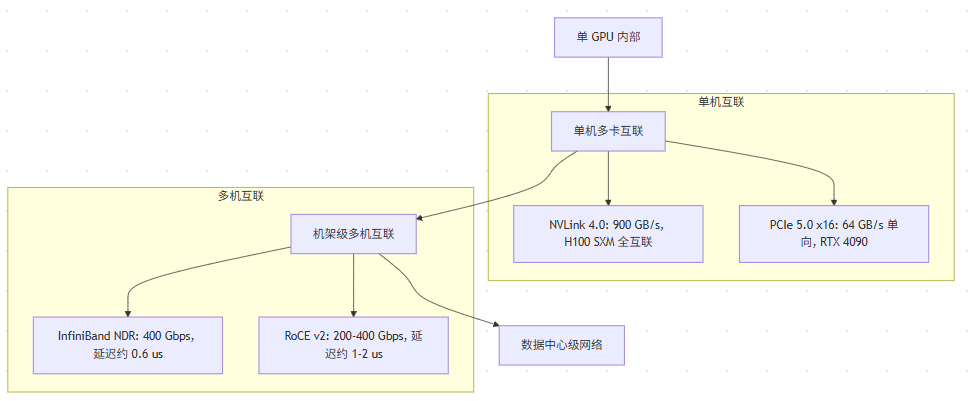
互联层级图
互联带宽的层次差异 :
PCIe:为什么不够用
PCIe 带宽数据
为什么 PCIe 不能做 TP 通信
以 70B 模型 TP=4 为例,每卡持有约 17.5B 参数。每次前向传播需要在 GPU 间交换激活值(activation):
PCIe 4.0 x16(32 GB/s 单向)看似够用,但实际上还有 All-Reduce、All-Gather 等集体通信操作,总通信量远大于此。更关键的是 延迟 :
结论 :PCIe 可以做模型并行中的 PP(流水线并行,通信频率低),但不能做 TP(张量并行,通信频率高)。
PCIe 拓扑限制
PCIe 是 点到点总线 ,经过 CPU Root Complex 或 PCIe Switch。这意味着:
NVLink:GPU 间的高速公路
NVLink 原理
NVLink 是 NVIDIA 专有的 GPU-GPU 互连技术,本质是 高速点对点串行链路 :
NVLink vs PCIe 对比
为什么 TP 需要 NVLink
张量并行(Tensor Parallelism)要求每层的前向传播中都要做 All-Reduce 或 All-Gather 通信:
NVLink 代际对比
NVSwitch:全互联的枢纽
原理
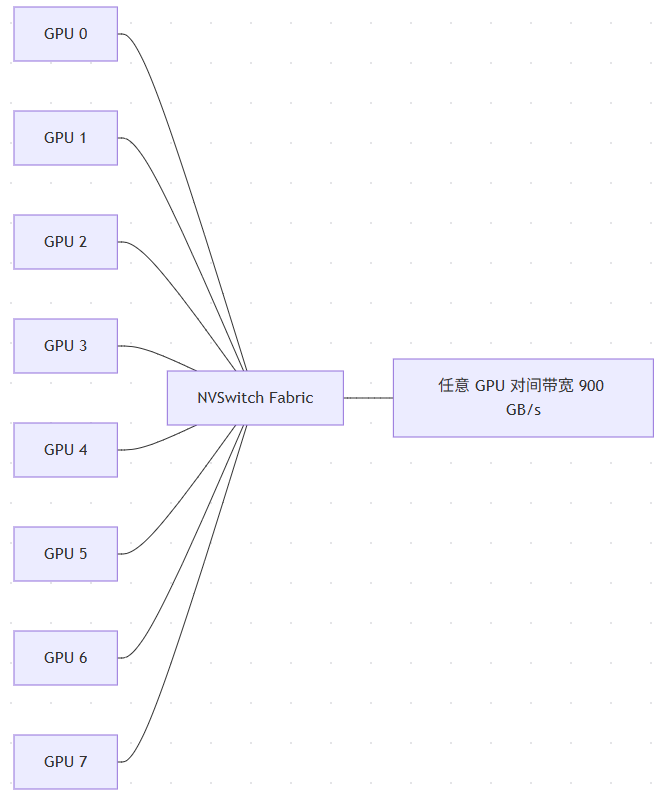
NVSwitch 是一个 高速交换芯片 ,将多个 GPU 的 NVLink 端口连接起来,实现 全互联(fully-connected)拓扑 :
任意 GPU 对间带宽 900 GB/s
NVSwitch 带宽计算
以 H100 SXM 8-GPU 为例:
多机互联:InfiniBand vs RoCE
RDMA 基础
RDMA(Remote Direct Memory Access) 允许一台机器直接读写另一台机器的内存, 绕过 CPU 和 OS 内核 :
RDMA 有三种实现方式:
InfiniBand vs RoCE 对比
不同互连下的 TP 通信延迟
以 70B 模型 TP=8 为例(每层 All-Reduce):
注:跨服务器 TP 的延迟还包括序列化/反序列化、网络栈开销,实际数字会比纯硬件延迟大很多。
部署视角:网络规划建议
单机多卡部署(推荐)
+---------------------------------------------+| HGX H100 8-GPU 服务器 || || GPU0 <-> NVLink <-> GPU1 <-> NVLink ... || | | | || +-------- NVSwitch(全互联)-------------+ || 每对 900 GB/s || || 对外:2x InfiniBand NDR 400G |+---------------------------------------------+
多机多卡部署(不推荐用于 TP)
如果必须在多机之间做 TP(如模型太大单机放不下),需要:
网络规划 checklist
实际网络拓扑示例
                    +-----------------+
                    |   Management    |
                    |   Network       |
                    +--------+--------+
                             |
        +--------------------+--------------------+
        |                    |                    |
  +-----+------+      +-----+------+      +-----+------+
  | IB Switch  |      | IB Switch  |      | IB Switch  |
  |   #1       |      |   #2       |      |   #3       |
  +-----+------+      +-----+------+      +-----+------+
        |                 |                  |
   +----+----+       +----+----+        +----+----+
   | HGX H100|       | HGX H100|        | HGX H100|
   | 8-GPU   |       | 8-GPU   |        | 8-GPU   |
   +---------+       +---------+        +---------+
每台 HGX H100 服务器通过 2 条 IB NDR 链路分别连接到不同的 IB Switch,实现冗余。
面试视角
常考问题
进阶问题
最佳实践
 学习助手