用低精度表示高精度数值,在可控精度损失下将显存压缩 2-4 倍、推理速度提升 1.5-3 倍
核心概念(含 Mermaid 图)
什么是量化
量化(Quantization)是将连续的高精度数值映射到离散的低精度表示的过程。在 LLM 推理中,就是把模型权重、激活值、KV Cache 从 FP32/FP16/BF16 转换为 INT8/INT4/FP8 等低精度格式。
核心收益 :
术语说明 :GEMM 是最基础的线性代数运算,Transformer 中绝大多数计算(QKV 投影、FFN)都可以表示为 GEMM。Tensor Core 是 NVIDIA GPU 中专门加速 GEMM 的硬件单元。
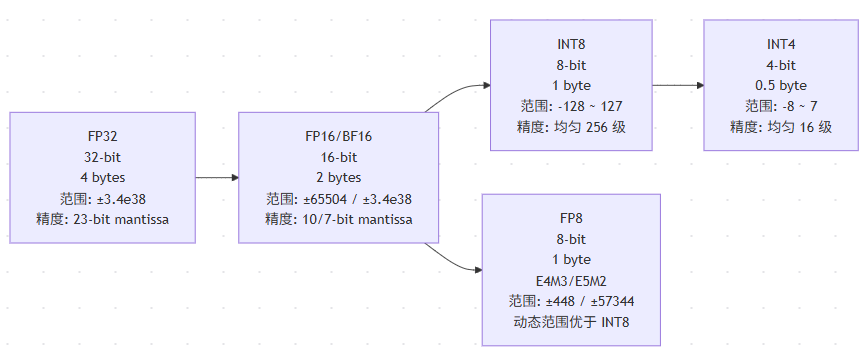
精度演进:FP32 → FP16 → INT8 → INT4 → FP8
注:浮点数由三部分组成——sign(符号位)、exponent(指数位,决定数值范围)、mantissa(尾数/小数位,决定精度)。FP16 比 FP32 减少了 exponent 和 mantissa 的位数,INT 格式则完全没有 exponent,用均匀分布的离散值表示。
量化的数学原理
在讲公式之前,先建立一个直觉: 量化就是把"连续的温度值"压缩到"整数档位"。
想象你有 0-100°C 的温度计,要压缩到 0-255 的整数。你需要知道"每个整数代表多少度"——这就是 scale (缩放因子)。如果范围是 0-100°C,scale = 100/255 ≈ 0.39,意味着"每个整数代表 0.39°C"。
最常用的对称均匀量化公式:
量化: q = round(x / s) + z反量化: x_hat = (q - z) * s其中: x → 原始浮点值(如模型权重 1.5) q → 量化后的整数(INT8 范围 [-128, 127]) s → 缩放因子(scale),相当于"每个整数代表多少浮点值" s = max(|x|) / 127,即把最大权重映射到 127 z → 零点(zero-point),用于对齐浮点 0 到整数 0 对称量化时 z=0,因为浮点 0 直接对应整数 0 x_hat → 反量化后的近似值,和原始值的差异就是量化误差
示例 :权重范围为 [-3.2, 3.2],对称 INT8 量化
s = 3.2 / 127 ≈ 0.0252x = 1.5 → q = round(1.5 / 0.0252) = round(59.52) = 60反量化: x_hat = 60 * 0.0252 = 1.512 → 误差 0.012
当数据分布不对称时(如激活值 ReLU 后全为正),使用非对称量化:
q = round((x - x_min) / (x_max - x_min) * 255)反量化: x_hat = q * (x_max - x_min) / 255 + x_min
此时零点 z = round(x_min / s),用于对齐浮点 0 到整数 0。
为什么量化能节省显存:具体字节数对比
70B 模型在不同精度下的显存占用:FP32: 70B × 4 bytes = 280 GB → 需要 4× A100-80GFP16: 70B × 2 bytes = 140 GB → 需要 2× A100-80GINT8: 70B × 1 byte = 70 GB → 1× A100-80GINT4: 70B × 0.5 byte = 35 GB → 1× A100-80G,余量可加大 batchFP8: 70B × 1 byte = 70 GB → 1× A100-80G/H100-80G加上 KV Cache 后的完整显存预算(batch=16, seq=8192, GQA-8): FP16 权重 + FP16 KV: 140 + 64 = 204 GB → OOM on 1× A100 INT8 权重 + INT8 KV: 70 + 32 = 102 GB → OOM on 1× A100 INT4 权重 + INT8 KV: 35 + 32 = 67 GB → 可行!余量给激活值
为什么量化能提升速度
NVIDIA GPU Tensor Core 理论吞吐量(TFLOPS,以 A100-80G 为例):FP32: 19.5 TFLOPSTF32: 156 TFLOPS (8x FP32)FP16: 312 TFLOPS (16x FP32)BF16: 312 TFLOPS (16x FP32)INT8: 624 TFLOPS (32x FP32) → INT8 GEMM 是 FP16 的 2xFP8(E4M3):1979 TFLOPS (H100) → FP8 是 FP16 的 ~6x (H100)带宽角度(A100-80G HBM2e): HBM2e 带宽: 2.0 TB/s INT8 权重体积是 FP16 的 1/2 → 权重访存时间减半 对于 weight-bound 的 decode 阶段,直接转化为延迟减半 > weight-bound(访存受限):瓶颈在从显存读取权重的速度,而非计算速度。 > 类比:做饭时等水烧开(IO 慢),而不是等切菜(计算慢)。实际推理加速比(decode 阶段,batch=1): FP16 → INT8: ~1.5-2x FP16 → INT4: ~2-3x FP16 → FP8 (H100): ~1.5-2x
量化精度损失的来源
精度损失的三大来源:1. 截断误差(Clipping) - 超过量化范围的异常值被截断到 max/min - 影响:权重分布中的 outlier 被削平 - 缓解:扩大量化范围或使用非对称量化2. 舍入误差(Rounding) - round(x/s) 引入的最大误差 = s/2 - 影响:所有值都有微小扰动,累积后可能显著 - 缓解:更细粒度的 per-group/per-token 量化3. 异常值敏感性(Outlier Impact) - LLM 中存在少量 extreme activation(magnitude 远超其他值) - 这些 outlier 撑大了 scale,导致普通值的量化粒度变粗 - 影响:这是 LLM 量化最大的精度杀手 - 缓解:SmoothQuant / AWQ 等异常值感知方案
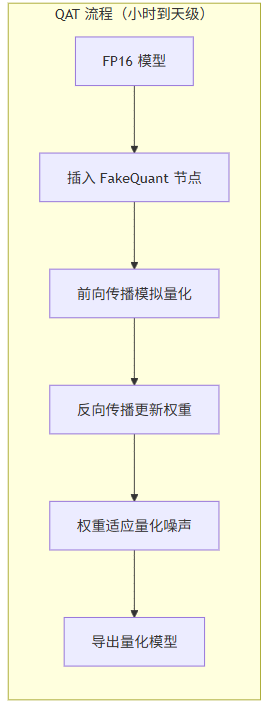
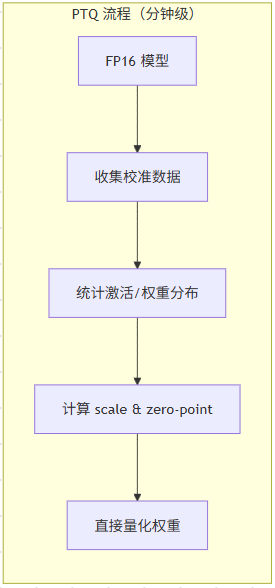
Post-training Quantization (PTQ) vs Quantization-Aware Training (QAT)
各主流模型对量化的原生支持
部署视角
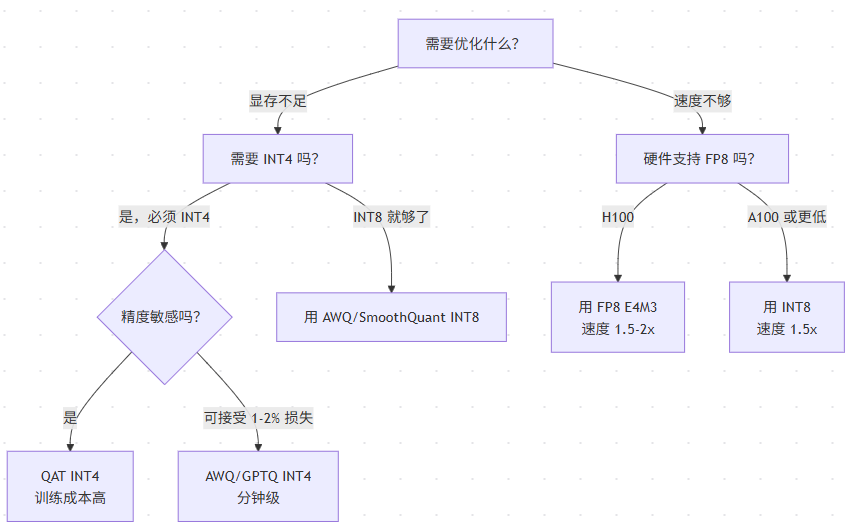
量化决策树
生产环境量化检查清单
量化与 vLLM/SGLang 的兼容性
面试视角
面试官常问问题
Q1: "简单解释一下量化是什么?为什么 LLM 可以量化?"
满分回答要点:
Q2: "INT8 量化会导致多少精度损失?什么情况下损失最大?"
Q3: "量化的 trade-off 是什么?什么时候不该量化?"
Q4: "为什么 INT8 GEMM 比 FP16 GEMM 快?"
Q5: "per-tensor、per-channel、per-group 量化各适用于什么场景?"
最佳实践
量化入门推荐
避坑指南
 学习助手