当模型参数超过单卡显存容量时,需要将模型拆分到多块 GPU 上。本模块讲解分布式推理的核心概念和并行策略。
为什么这个模块对 FDE 至关重要
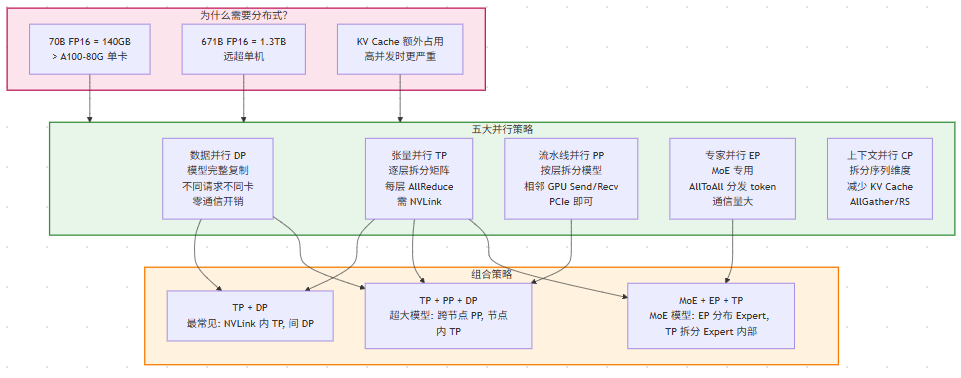
70B 模型的 FP16 权重是 140GB,远超单张 A100-80G 的容量。671B 的 DeepSeek-V3 更是需要 1.3TB。分布式推理是唯一解法,但不同的并行策略带来的性能代价完全不同:
分布式推理的核心矛盾:计算可以线性拆分,但通信开销不是线性的。选择错误的并行策略,可能让 8 张卡的性能还不如 4 张。
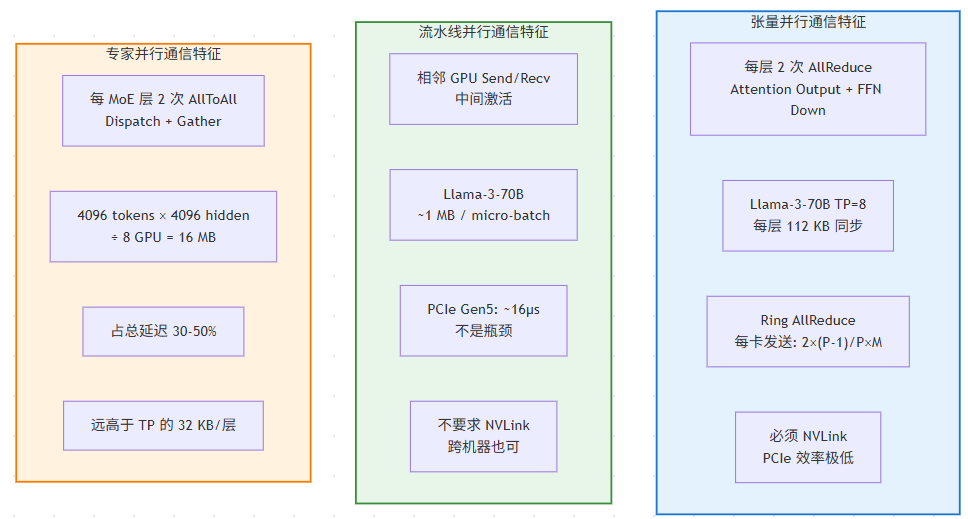
并行策略通信开销对比
通信开销量化对比
关键数字:TP=4 时,每卡每次 AllReduce 发送 1.5 倍的数据量;TP=8 时发送 1.75 倍。
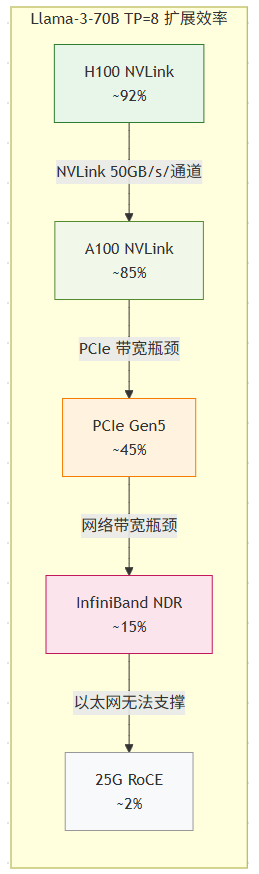
TP 扩展效率(不同互联方式)
结论:TP 必须在 NVLink 域内执行。超过 NVLink 范围(通常是单机 8 卡),TP 的效率急剧下降。
流水线并行的 Bubble 分析
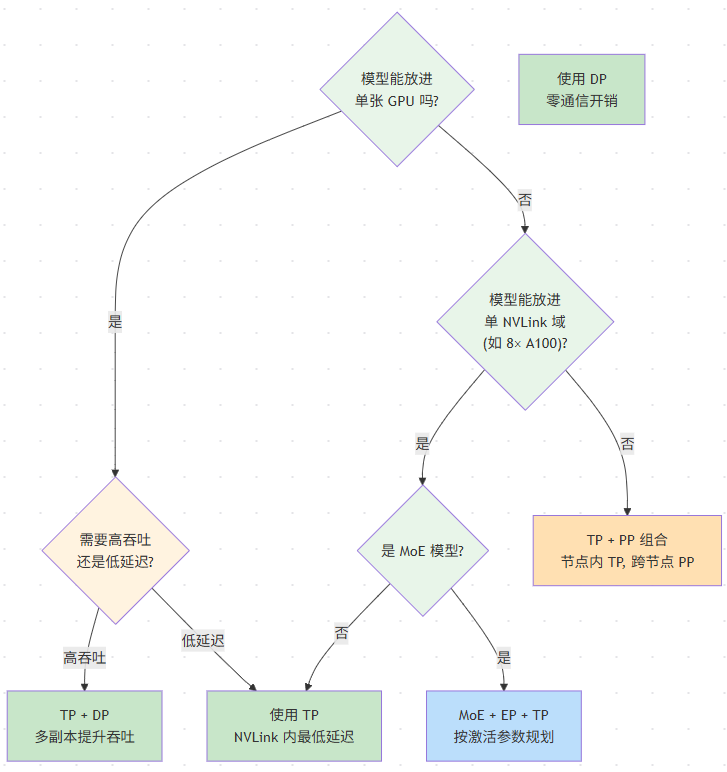
策略选择决策树
典型部署配置
内存估算公式
单卡显存:
KV Cache:
MoE 显存:
学习路径
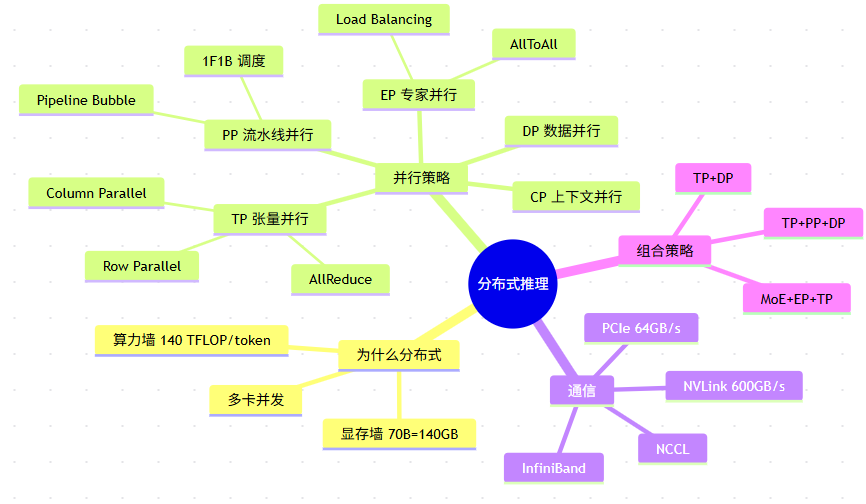
模块知识结构图
 学习助手