一句话概括:SGLang 是面向 Agent 和结构化生成场景的推理引擎,其核心创新 RadixAttention 通过前缀树管理 KV Cache,配合 FSM 约束生成,在 Agent 工作流中可实现 2-5x 的性能提升。
前置知识
SGLang 的定位
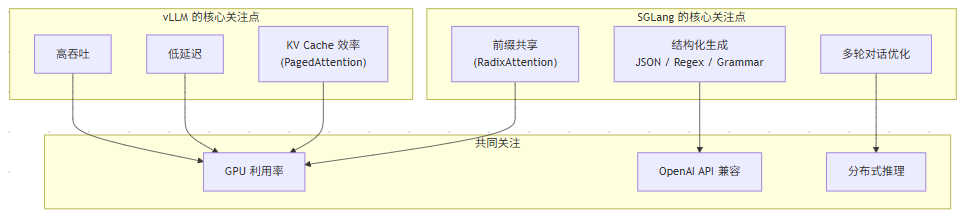
SGLang(Structured Generation Language)由 UC Berkeley 和 CMU 联合开发,其设计哲学是: 推理引擎不仅要跑得快,还要理解生成的结构。
SGLang 的两大核心创新:
RadixAttention 原理
问题分析
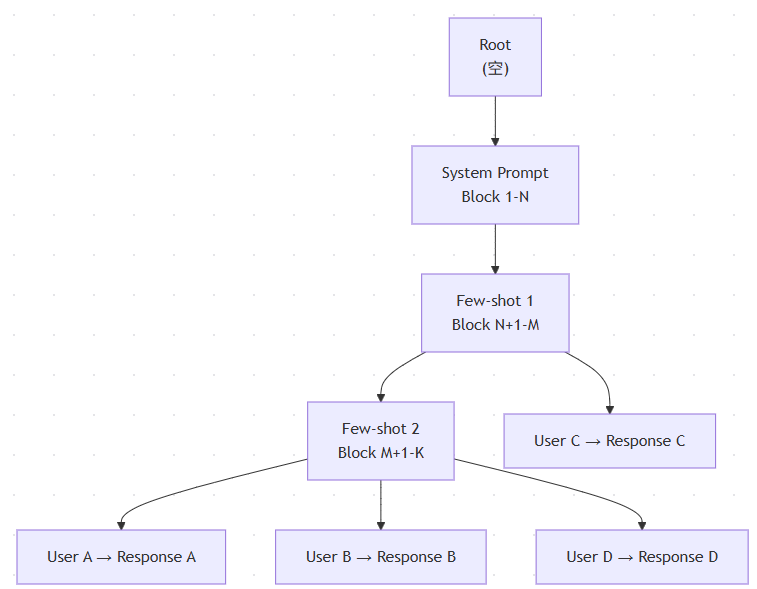
在 Agent 和多轮对话场景中,大量请求共享相同的前缀:
Request 1: [System Prompt] [Few-shot 1] [Few-shot 2] [User Question A]Request 2: [System Prompt] [Few-shot 1] [Few-shot 2] [User Question B]Request 3: [System Prompt] [Few-shot 1] [User Question C]Request 4: [System Prompt] [Few-shot 1] [Few-shot 2] [User Question D]
使用传统的 KV Cache 管理(如 vLLM 的 PagedAttention),每个请求独立存储完整的 KV Cache,即使前缀相同也各自计算和存储。
RadixAttention 的解决方案
核心机制 :
定量收益
假设一个典型 Agent 场景:
实际场景中,由于 trie 管理的 overhead 和部分匹配的不完美,收益约为 2-5x 。
RadixAttention vs vLLM Prefix Caching
两者都利用了 prefix 共享,但有本质区别:
结构化生成
为什么需要结构化生成
LLM 的原生输出是自由文本,但在许多场景下我们需要严格格式化的输出:
# 场景 1:Function Calling# 期望输出严格的 JSON 格式{ "name": "search_database", "arguments": { "query": "latest products", "limit": 10 }}# 场景 2:数据抽取# 从非结构化文本中抽取结构化信息{ "person": {"name": "John", "age": 30}, "company": {"name": "TechCorp", "role": "Engineer"}}# 场景 3:代码生成# 生成语法正确的 Python 代码def fibonacci(n: int) -> int: if n <= 1: return n return fibonacci(n-1) + fibonacci(n-2)
如果没有结构化生成,LLM 可能输出:
FSM 约束生成原理
Parse error on line 34: ...掉 } LBrace -. 只能输出双引号 .-> KeySt --------------------^ Expecting 'SPACE', 'NL', 'DESCR', '-->', 'HIDE_EMPTY', 'scale', 'COMPOSIT_STATE', 'STRUCT_STOP', 'STATE_DESCR', 'ID', 'FORK', 'JOIN', 'CHOICE', 'CONCURRENT', 'note', 'acc_title', 'acc_descr', 'acc_descr_multiline_value', 'CLICK', 'STRING', 'HREF', 'classDef', 'style', 'class', 'direction_tb', 'direction_bt', 'direction_rl', 'direction_lr', 'EDGE_STATE', 'STYLE_SEPARATOR', got 'INVALID'
工作原理 :
SGLang 支持的约束类型
使用示例
from sglang import function, assistant, user, genimport sglang as sgl@sgl.functiondef extract_info(s, text): s += user(f"从以下文本中提取人物信息,以 JSON 格式返回:\n{text}") s += assistant(gen("json_output", max_tokens=256, regex=r'\{.*\}', # 确保输出是 JSON ))# 运行时确保输出符合 JSON 格式result = extract_info.run( text="张三,35岁,在TechCorp担任高级工程师。")
使用 JSON Schema 约束:
import sglang as sglfrom sglang.srt.constrained import build_regex_from_schemaschema = '''{ "type": "object", "properties": { "name": {"type": "string"}, "age": {"type": "integer"}, "company": {"type": "string"} }, "required": ["name", "age", "company"]}'''# 编译 schema 为 regex(内部使用 FSM)regex = build_regex_from_schema(schema)# 生成时强制遵守 schemaresponse = sgl.gen( prompt="Extract: 张三, 35, TechCorp", regex=regex)# 保证输出是合法的 JSON: {"name": "张三", "age": 35, "company": "TechCorp"}
SGLang vs vLLM 对比
什么时候选 SGLang?
什么时候选 vLLM?
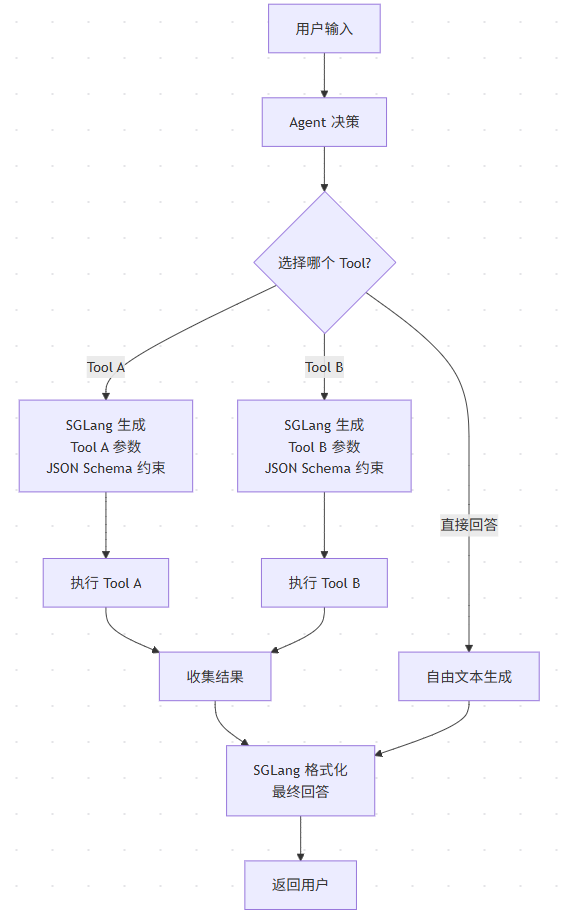
Function Calling 场景中的应用
在 Agent 场景中,结构化生成是关键基础设施:
结构化生成在 Function Calling 中的价值 :
面试视角
为什么结构化生成对 Agent 场景很重要?
推荐回答 :
"Agent 场景的核心是 LLM 与外部工具/系统的交互,这种交互要求 LLM 的输出是 机器可解析的精确格式 。
没有结构化生成时,LLM 调用工具的典型流程是:
问题在于第 3 步:LLM 作为概率模型,天然会偶尔输出格式不正确的内容。这会引入额外的延迟(重试)和系统复杂度(错误处理逻辑)。
结构化生成通过 FSM 在 token 级别约束输出,从根本上保证了 100% 的格式正确率 。在 Agent 场景中,这意味着:
追问:FSM 约束生成会带来什么开销?
总体而言,结构化生成的额外开销在 5% 以内,但换来的是 100% 的格式正确率,这个 trade-off 在 Agent 场景中是非常值得的。
RadixAttention 的局限性是什么?
SGLang 能否替代 vLLM 作为通用推理引擎?
目前还不建议。原因:
但在 Agent 和结构化输出场景下,SGLang 是更优选择。建议的架构是:
通用推理请求 → vLLM 集群Agent/结构化请求 → SGLang 集群
最佳实践
启动配置
# SGLang 服务启动(类似 vLLM 的体验)python -m sglang.launch_server \ --model-path meta-llama/Llama-3-8B-Instruct \ --host 0.0.0.0 \ --port 30000 \ --mem-fraction-static 0.85 \ --max-running-requests 256
性能调优建议
与 vLLM 的选择决策
你的场景是什么?├── 通用推理服务(聊天、补全)│ └── 选 vLLM├── Agent / Function Calling│ └── 选 SGLang├── 多轮对话 + 相同 system prompt│ └── 优先 SGLang(RadixAttention 优势大)├── 需要严格的 JSON / 代码输出│ └── 选 SGLang├── 需要最大的模型覆盖│ └── 选 vLLM└── 不确定 └── 先选 vLLM,后续根据需求评估 SGLang
 学习助手