技术指标再漂亮,如果无法映射到业务价值,就无法获得持续投入。本章讲解如何将 LLM 的技术指标转化为 CEO 听得懂的业务语言。
前置知识
为什么技术指标不够
技术团队往往关注 TTFT(首 Token 延迟)、吞吐量、GPU 利用率等指标,但业务决策者关心的是完全不同的东西:
工程师汇报: 我们的模型 TTFT 降低到 200ms,吞吐量提升 3 倍!CEO 的反应: 所以呢?这能为公司省多少钱?多赚多少钱?工程师汇报: AI 工单处理准确率 92%,平均处理时长从 15 分钟降到 3 分钟!CEO 的反应: 很好,这意味着什么?需要多少投入?ROI 是多少?
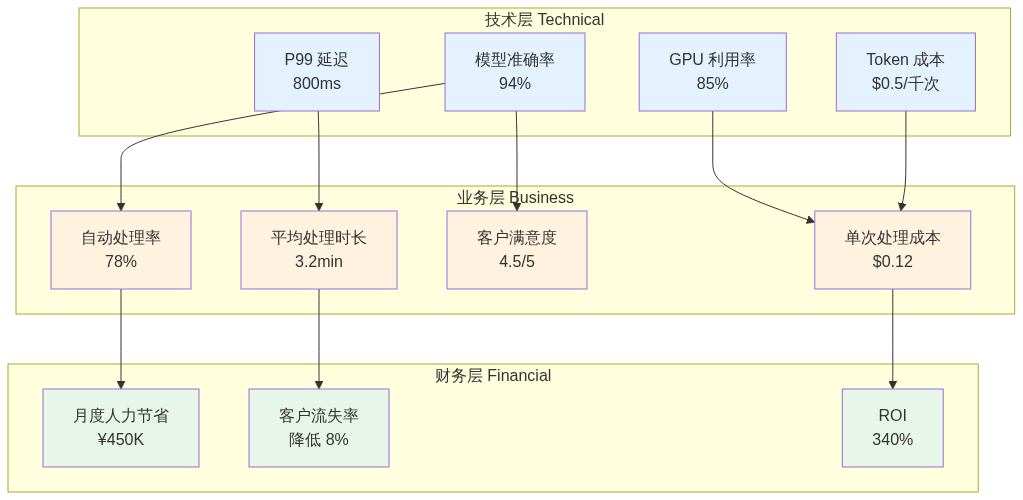
核心原则: 每个技术指标都必须能映射到至少一个业务指标。
技术指标 vs 业务指标映射
指标映射架构
映射公式示例:
单次处理成本 = (GPU 小时成本 / 每小时处理工单数) + API 调用成本月度人力节省 = (AI 处理工单数 × 人工平均处理时间 × 人工时薪) - AI 运营成本ROI = (月度人力节省 + 额外收入 - AI 总成本) / AI 总成本 × 100%
如何定义 AI 项目的成功指标(OKR 方法)
用 OKR 框架定义 AI 项目目标,确保技术目标和业务目标对齐:
Objective: 用 AI 将客服工单处理效率提升 50%Key Results: KR1: 工单自动处理率从 20% 提升到 60%(业务指标) KR2: 平均工单处理时长从 15 分钟降到 8 分钟(业务指标) KR3: AI 处理工单的客户满意度 ≥ 人工处理的 90%(质量指标) KR4: 单次工单处理成本降低 40%(成本指标) KR5: 模型幻觉率 < 3%(技术指标,支撑 KR3)
制定 OKR 的注意事项:
A/B 测试在 AI 项目中的应用
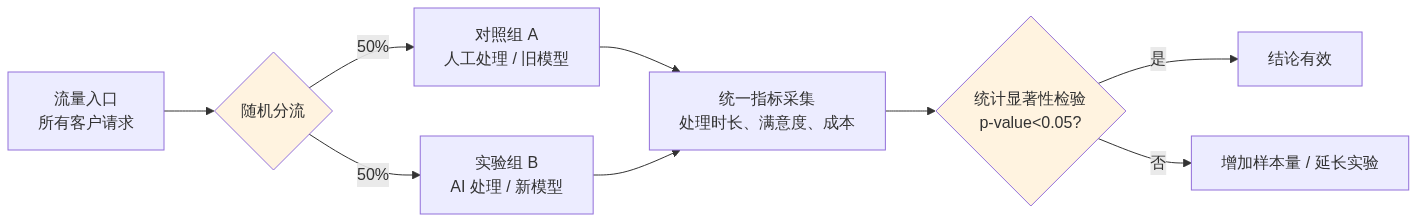
实验设计
关键设计要素
统计显著性判断
from scipy import stats# A/B 测试:比较两组客户满意度control_scores = [4.2, 3.8, 4.5, ...] # 对照组treatment_scores = [4.5, 4.1, 4.7, ...] # 实验组t_stat, p_value = stats.ttest_ind(treatment_scores, control_scores)if p_value < 0.05: print(f"结果统计显著 (p={p_value:.4f}),实验组优于对照组")else: print(f"结果不显著 (p={p_value:.4f}),需要更多样本")
常见陷阱
Drift Detection — 模型输出质量退化检测
为什么需要
AI 模型的输出质量会随时间退化,原因包括:
典型案例:
  上线时 AI 分类准确率 95% → 3 个月后降至 82%
  原因:新增了 3 种工单类型,但模型没见过这些类型的样本
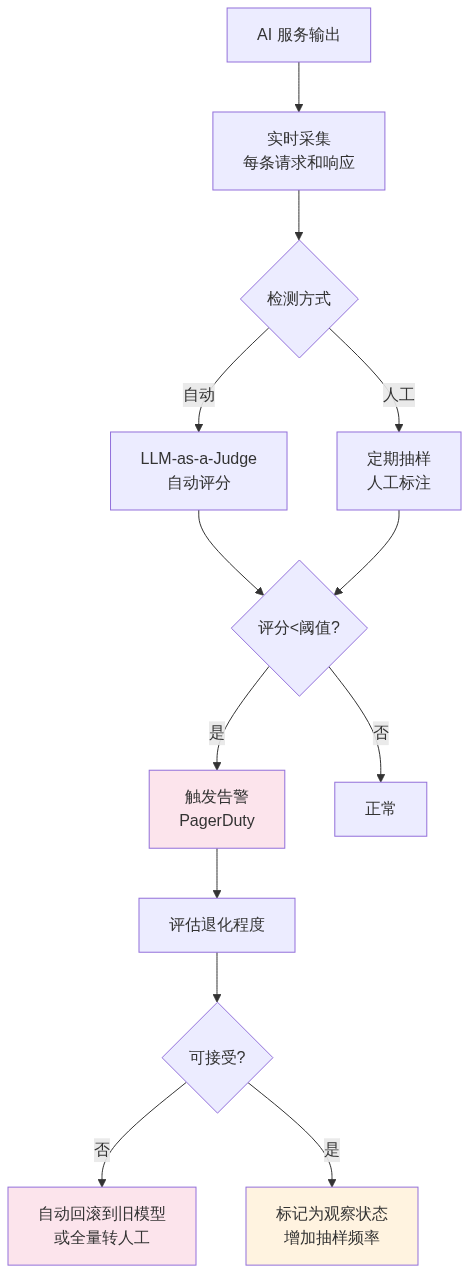
检测方法
LLM-as-a-Judge 实现
from pydantic import BaseModelclass QualityScore(BaseModel): accuracy: int # 1-5 分 completeness: int # 1-5 分 helpfulness: int # 1-5 分 overall: float # 0-100def judge_response(request: str, response: str, ground_truth: str) -> QualityScore: """用强模型评估弱模型的输出质量""" prompt = f"""作为评估专家,请对以下 AI 回答进行评分:用户请求:{request}AI 回答:{response}参考答案:{ground_truth}请从准确性、完整性、有用性三个维度评分(1-5 分),并给出总体得分(0-100)。""" response = llm.with_structured_output(QualityScore).invoke(prompt) return response# 每日自动评估daily_scores = []for sample in daily_sample_100(): score = judge_response(sample.request, sample.response, sample.ground_truth) daily_scores.append(score.overall)avg_score = sum(daily_scores) / len(daily_scores)if avg_score < BASELINE_SCORE * 0.9: # 低于基线 10% 告警 alert(f"模型质量下降:当前 {avg_score:.1f},基线 {BASELINE_SCORE}")
告警与自动回滚策略
drift_detection:
  # 检测频率
  schedule: "*/6h"  # 每 6 小时评估一次

  # 告警阈值
  alert:
    quality_drop_threshold: 10%  # 质量下降超过 10% 告警
    volume_threshold: 500        # 评估样本至少 500 条

  # 自动回滚条件
  auto_rollback:
    conditions:
      - quality_drop > 20% AND duration > 24h
      - error_rate > 15% AND duration > 1h
      - customer_complaint_rate > 5%

  # 回滚动作
  rollback_actions:
    - switch_to_previous_model  # 切回上一个稳定版本
    - increase_human_review     # 提升人工审核比例
    - enable_fallback_rules     # 启用规则引擎兜底
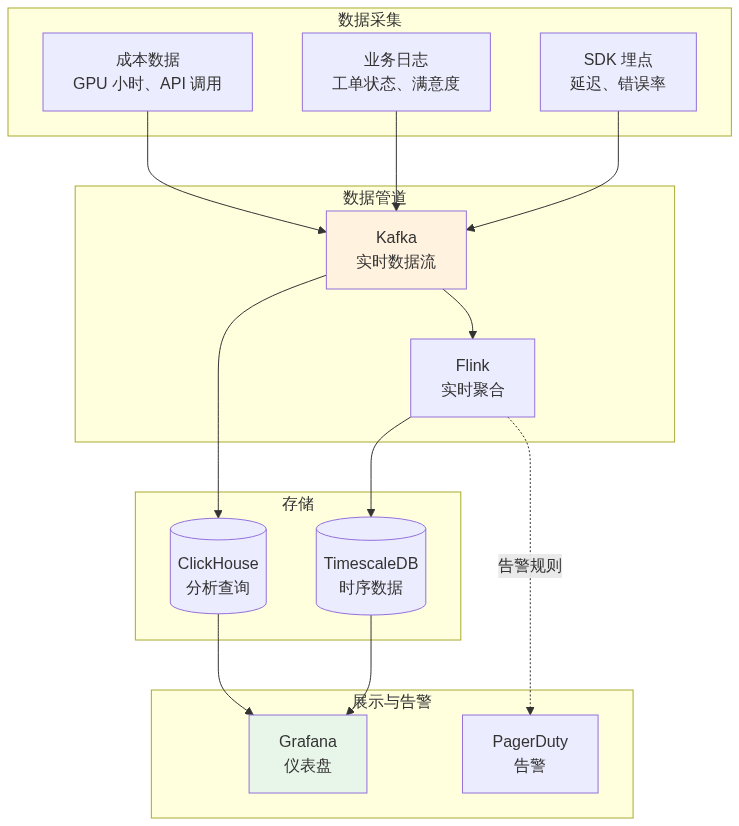
部署视角:指标采集架构
关键仪表盘设计:
面试视角
"怎么向 CEO 汇报 AI 项目的效果?"满分回答
面试官:你怎么向 CEO 汇报 AI 项目的效果?1. 先说结论,不说技术细节(30 秒) → "AI 客服上线 3 个月,自动处理了 62% 的工单,节省了 ¥450K/月人力成本, 客户满意度保持在 4.5/5,和人工持平。"2. 展示 ROI 数据(30 秒) → "投入:AI 基础设施 + 开发成本 ≈ ¥200K/月 节省:减少 8 个客服人员 ≈ ¥480K/月 ROI:(480-200)/200 = 140%,预计 2 个月回本"3. 展示趋势和对比(30 秒) → "和上线前比:平均处理时长从 15min 降到 3.2min(-79%) 和上季度比:客户满意度从 4.3 提升到 4.5 自动处理率:从 20% 逐月提升到 62%,每月增长约 15%"4. 坦诚风险和下一步计划(30 秒) → "当前风险:模型准确率在新型工单上有下降趋势(已发现并告警) 下一步:计划扩展到售前咨询场景,预计可再节省 ¥200K/月 需要什么支持:需要增加 1 个数据工程师做数据管道优化"关键要点:用数字说话,先说结果再说过程,坦诚风险,给出清晰的下一步。
最佳实践
 学习助手