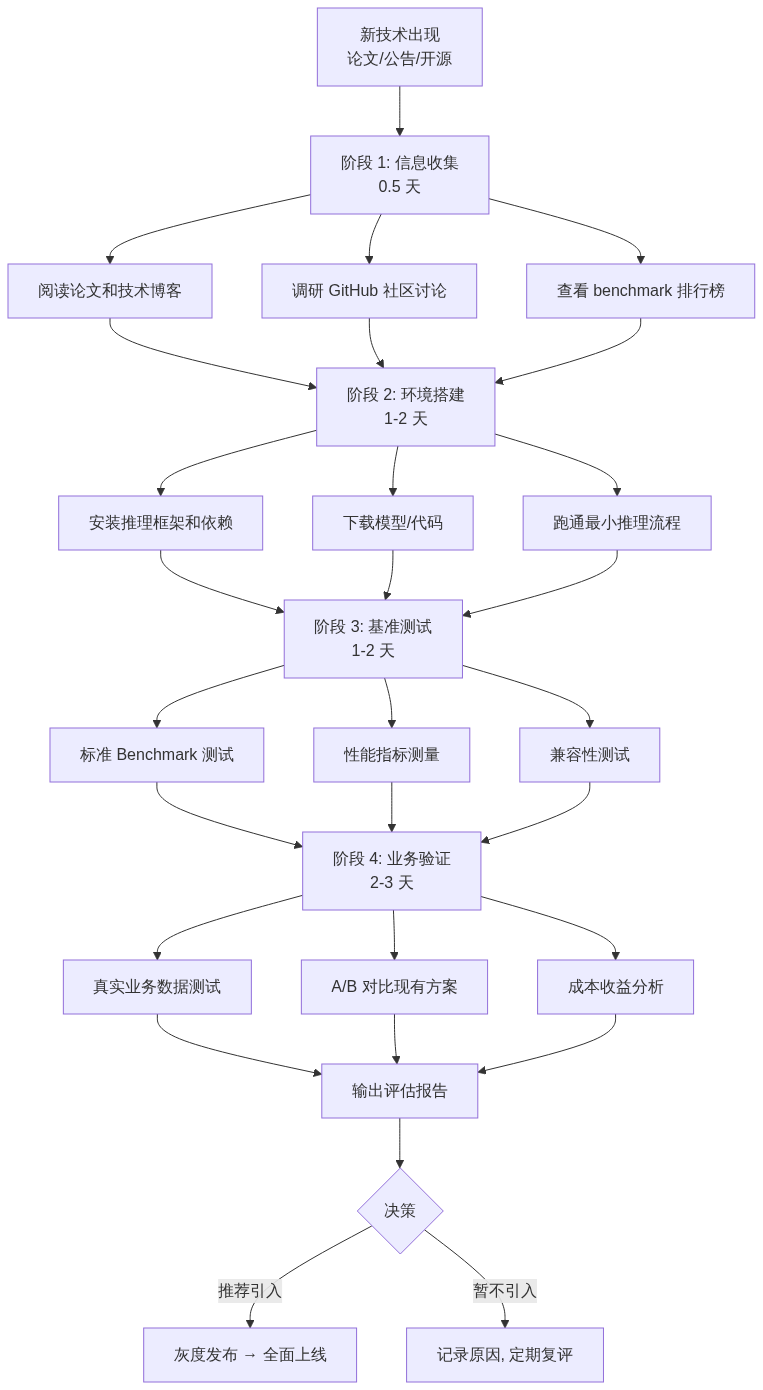
用系统化的四步法评估新技术:信息收集 → 环境搭建 → 基准测试 → 业务验证,确保技术选型有据可依。
核心概念:新模型/技术评估流程
评估维度
维度一:精度(Accuracy)
维度二:性能(Performance)
性能测试模板:
Input tokens | TTFT (P50/P99) | TPOT (ms) | Decode tok/s----------------|----------------|-----------|-------------100 | 15ms / 25ms | 12ms | 83500 | 50ms / 85ms | 12ms | 832000 | 180ms / 300ms | 15ms | 674000 | 350ms / 580ms | 20ms | 50
维度三:兼容性(Compatibility)
维度四:成本(Cost)
维度五:生态与风险(Ecosystem & Risk)
Benchmark 工具选择
标准化 Benchmark
性能 Benchmark
自定义 Benchmark
# 性能测试脚本示例import timefrom vllm import LLM, SamplingParamsllm = LLM(model="model-path")prompts = [ "What is the capital of France?" * 10, # short prompt "Write a detailed essay about..." * 100, # long prompt]for prompt in prompts: start = time.time() output = llm.generate(prompt, SamplingParams(max_tokens=200)) elapsed = time.time() - start tokens_generated = len(output[0].outputs[0].token_ids) print(f"TTFT: {output[0].metrics.first_token_time*1000:.0f}ms") print(f"TPOT: {output[0].metrics.token_time*1000:.0f}ms") print(f"Throughput: {tokens_generated/elapsed:.0f} tok/s")
性能测试标准流程
1. Prefill 性能测试
目标:测量不同 input 长度下的首 token 延迟(TTFT)测试矩阵: Input tokens: [100, 500, 1000, 2000, 4000, 8000] 每个长度测 20 次,取 P50 和 P99预期关系: TTFT ≈ input_tokens × prefill_time_per_token Prefill 是 memory-bound,与模型大小线性相关
2. Decode 性能测试
目标:测量 decode 阶段的吞吐量(tokens/s)和延迟(TPOT)测试矩阵: Batch size: [1, 4, 8, 16, 32] Output tokens: [100, 200, 500] 测量: - Decode throughput (total tokens/s) - TPOT (ms per output token) - 最大并发请求数(延迟 < SLA 阈值)预期关系: Batch=1 时:TPOT 最低,吞吐最低 Batch=16+ 时:吞吐最高,TPOT 可能升高
3. 端到端压力测试
目标:模拟真实流量的 QPS、延迟和稳定性工具:Locust / k6测试场景: - 稳态 QPS:100 QPS,持续 10 分钟 - 突发 QPS:从 50 QPS 骤升到 500 QPS - 长时间运行:10 QPS,持续 24 小时(检测显存泄漏)关注指标: - P50/P95/P99 延迟 - 错误率(OOM、超时) - GPU 利用率 - 显存使用趋势
评估报告模板
# [技术/模型名称] 评估报告## 1. 概述- 来源:论文链接 / GitHub / 官方公告- 评估日期:YYYY-MM-DD- 评估人:XXX- 结论摘要:推荐 / 有条件推荐 / 不推荐## 2. 技术原理- 核心创新点(3-5 句话)- 与现有方案的差异## 3. 精度评估| Benchmark | 现有方案 | 新方案 | 变化 ||-----------|---------|--------|------|| MMLU | 78.5% | 79.2% | +0.7pp || GSM8K | 85.0% | 86.1% | +1.1pp || ... | ... | ... | ... |## 4. 性能评估| 指标 | 现有方案 | 新方案 | 变化 ||------|---------|--------|------|| TTFT (100 tokens) | 15ms | 12ms | -20% || TPOT (batch=1) | 12ms | 10ms | -17% || Decode 吞吐 (batch=16) | 3500 tok/s | 4200 tok/s | +20% |## 5. 成本评估- 单 token 成本:$X vs $Y(变化 Z%)- GPU 需求变化:从 N 张降到/升到 M 张## 6. 兼容性- [x] vLLM 支持- [x] OpenAI API 兼容- [ ] 特殊硬件要求## 7. 风险- 许可证风险:XXX- 维护风险:XXX- 精度风险:XXX## 8. 适用场景- 推荐用于:XXX- 不推荐用于:XXX## 9. 结论和建议- [ ] 推荐引入,灰度发布- [ ] 有条件推荐,需解决 XXX 问题- [ ] 不推荐,原因:XXX- 后续计划:XXX
部署视角
评估流水线自动化
评估基础设施
面试视角
面试官可能问:
核心回答框架:
最佳实践
*前沿跟踪完成 → 进入 面试篇*
 学习助手