一句话概括核心:Mix-of-Experts 通过路由机制让每个 token 只激活部分 Expert,结合 Expert Parallel 将不同 Expert 分布到不同 GPU,实现"模型越大、激活越少"的高效推理。
前置知识
核心概念
MoE 架构回顾
MoE 的核心思想是将 FFN 层替换为多个 Expert(通常是小型 FFN),每个 token 通过 Router 选择 top-k 个 Expert 进行计算。
传统 FFN: Input → FFN → Output (所有 token 走同一个 FFN)MoE FFN: Input → Router → top-k Expert → 加权组合 → Output ↗ Expert_0 token_i → → Expert_1 (每个 token 只激活 2 个 Expert) ↘ Expert_7
关键参数 :
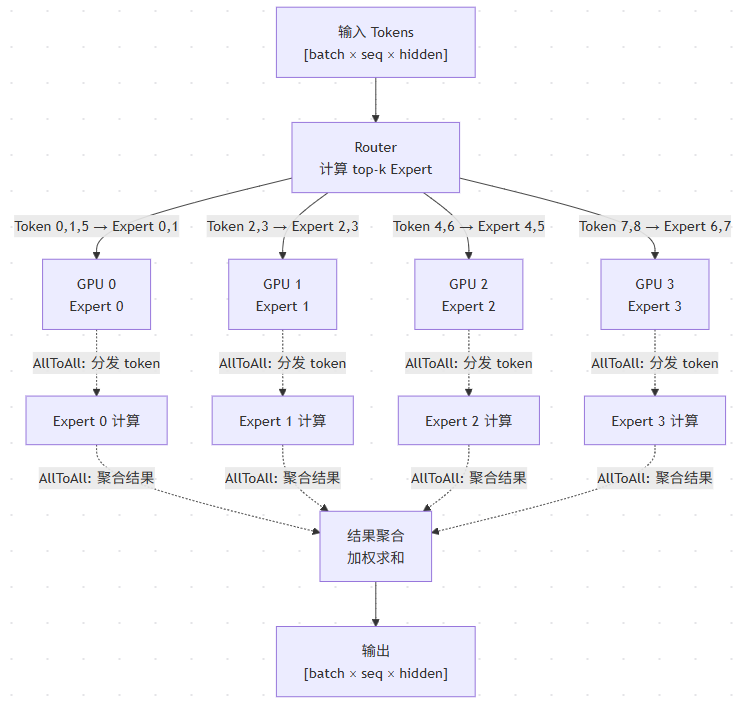
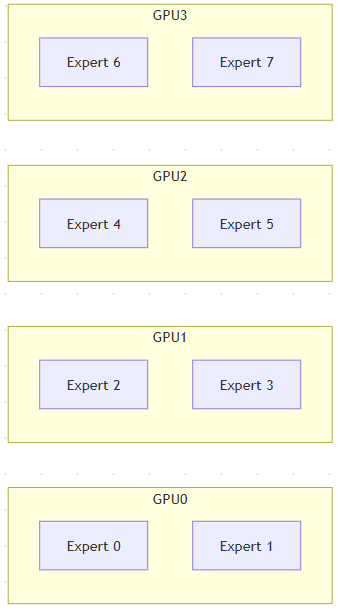
MoE 跨卡 Expert 分布
流程说明 :
AllToAll 通信详解
AllToAll 在 MoE 中的作用
MoE 中有两次关键的 AllToAll 通信:
Dispatch(前向分发):
     GPU_i 持有: 一部分 token
     需要发送到: 不同 GPU 上的对应 Expert
     通信模式: 每个 GPU 向所有 GPU 发送不同数据

Gather(结果聚合):
     各 GPU 计算完 Expert 输出
     需要将结果发回给持有原始 token 的 GPU
     通信模式: Dispatch 的逆操作
AllToAll 通信量计算
Dispatch 通信量 = tokens × top_k × hidden_size × 4 bytes / num_gpus以 Llama-MoE 为例: tokens = 4096 (batch × seq) top_k = 2 hidden_size = 4096 num_gpus = 8 通信量 = 4096 × 2 × 4096 × 4 / 8 = 16 MB 对比 TP 的 AllReduce: ~32 KB/layer MoE 的 AllToAll 通信量远大于 TP 的 AllReduce
AllToAll vs AllReduce
Expert Parallel vs Tensor Parallel 的组合
纯 Expert Parallel(EP)
每个 Expert 完整放在一张 GPU 上,适合 Expert 较小的场景。
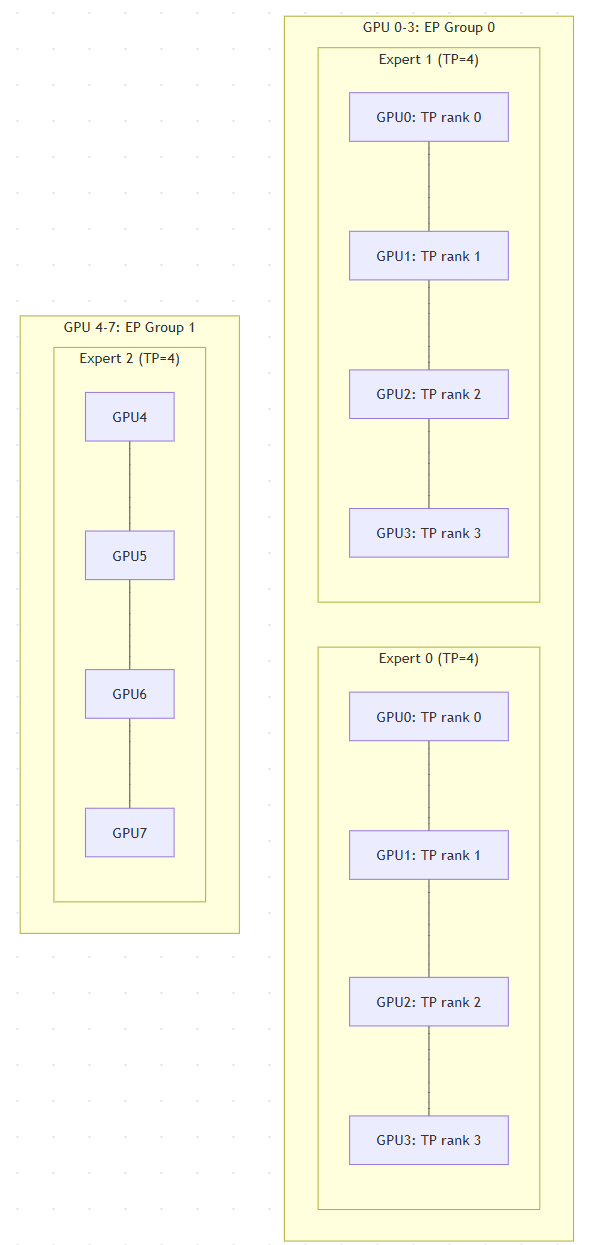
EP + TP 混合
当单个 Expert 很大时(如 DeepSeek-V3 的 Expert 本身就需要多卡),需要在 Expert 内部再做 TP:
并行策略选择
负载均衡策略
MoE 的核心挑战之一是 Expert 负载不均衡。如果所有 token 都路由到同一个 Expert,会导致:
Auxiliary Loss(辅助损失)
训练时添加辅助损失函数,鼓励均匀分配:
aux_loss = α × Σ(expert_i_fraction × expert_i_capacity_fraction)其中: expert_i_fraction = token 分配到 expert_i 的比例 expert_i_capacity_fraction = expert_i 使用容量占总容量的比例 α = 平衡系数(通常 0.01)目标: 最小化时,token 会均匀分布到所有 Expert
Capacity Factor
capacity_factor = max_tokens_per_expert / (total_tokens / num_experts)capacity_factor = 1.0: 严格均匀,超出丢弃capacity_factor = 1.25: 允许 25% 溢出,溢出 token 走残差连接capacity_factor = 2.0: 宽松分配,但可能导致显存浪费推理时通常设 1.0-1.25,保证负载均衡
推理时的负载均衡
推理时无法像训练那样通过 loss 调整,常见策略:
DeepSeek-V3 的 MLA + MoE 架构简析
DeepSeek-V3(671B 参数,激活 37B)是 MoE 架构的代表:
总参数: 671B激活参数: ~37B (每 token 只激活约 5.5% 的参数)架构特点:├── MLA (Multi-Head Latent Attention)│ ├── 低秩 KV 压缩(减少 KV Cache)│ └── 注意力计算高效├── MoE FFN│ ├── 256 个 Expert│ ├── 每 token 激活 top-8 Expert(实际 1 个 routed + 1 个 shared)│ └── 跨节点 Expert 分布(Expert Parallel)└── 并行策略 ├── 节点内 TP=4(Expert 内部) ├── Expert 跨节点分布(EP) └── 可能的 PP 跨节点分层
DeepSeek-V3 推理优势 :
MoE 部署的通信瓶颈和缓解策略
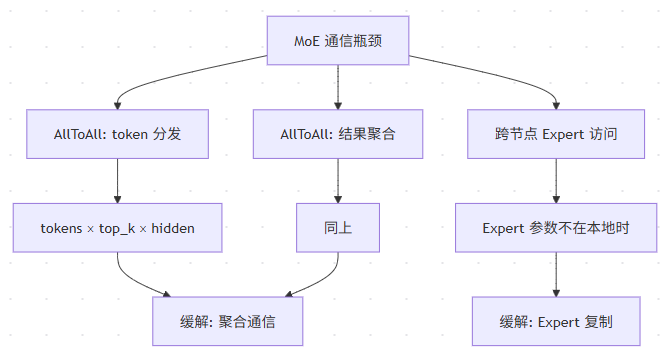
通信瓶颈分析
缓解策略
部署视角
vLLM 中的 MoE
# DeepSeek-V3 推理(MoE + EP)vllm serve deepseek-ai/DeepSeek-V3 \ --tensor-parallel-size 4 \ --enable-expert-parallel# MoE 模型需要注意 Expert 的分配
显存估算
MoE 显存 = (总参数量 / EP_size) × 2 bytes + KV_Cache × batch_size + Router buffer + AllToAll bufferDeepSeek-V3 EP=8: 权重显存 = 671B / 8 × 2 bytes = 168 GB 需要多卡或量化才能放下
面试视角
Q1: MoE 模型的并行策略如何选择?
决策框架 :
Q2: MoE 推理的主要性能瓶颈是什么?
三个层次 :
实际部署中,AllToAll 通信通常占 MoE 推理延迟的 30-50%。
Q3: 为什么 MoE 可以跨机部署而 TP 不行?
Q4: MoE 模型的负载均衡怎么做?
Q5: DeepSeek-V3 相比传统 MoE(如 Mixtral)有什么创新?
 学习助手