掌握推理加速前沿技术(Speculative Decoding、FP8/FP4、KV Cache Compression、Reasoning 优化等),在面试中展现技术深度和前瞻性。
核心概念:推理加速技术全景
技术分类详解
1. 算法层优化(减少计算量)
2. 数值精度优化(减少每操作计算量)
3. 内存优化(减少显存瓶颈)
2026 年推理技术状态
已生产标配(2024 之前成熟的技术)
这些技术已成为推理框架的默认配置,面试中不需要特别强调"前沿":
2025 年成熟并广泛采用的技术
这些技术在 2025 年完成从"实验"到"生产"的过渡,现在是 H100+/B200 环境的推荐配置:
1. EAGLE-2/3 Speculative Decoding
2. Prefill-Decode 分离架构(DistServe / MoonCake)
3. FP8 E4M3 on H100/B200
2025-2026 前沿研究方向
这些是正在从论文走向生产的技术,FDE 应该开始评估和实验:
1. SpecForge (2026-03) — 灵活的开源推测解码训练框架
2. FLy — Training-Free Loosely Speculative Decoding (2025-12)
3. CAS-Spec (NeurIPS 2025) — 级联自适应自推测
4. EdgeLLM (2026) — 端侧推理 + 推测解码
5. MXFP4/MXFP6 (H200/Rubin)
2026 年 FDE 新战场
Reasoning 模型推理优化
GPT-5、Claude 4/4.5、Gemini 3 等"思考模型"(Reasoning Models)引入了 Chain-of-Thought (CoT) 中间步骤,产生了全新的推理优化挑战:
传统模型:Prompt → Token1 → Token2 → ...Reasoning 模型:Prompt → [思考 Token × N] → 最终回答
关键挑战:
优化方向:
Agentic 推理优化
Agent 系统的核心瓶颈是"多轮工具调用"场景下的推理效率:
Agent Loop:
  思考 → 调用工具 → 等待结果 → 继续思考 → 调用下一个工具 → ...
MoE 大规模生产部署
Kimi K2(1 万亿参数 MoE)、Mistral Large(675B 总参数 / 41B 激活)等超大 MoE 模型进入生产:
部署挑战:
FP4 极致量化
Rubin GPU(2026)原生支持 FP4 Tensor Core,50 PFLOPS 推理性能:
意义:
端侧推理优化
EdgeLLM、手机 NPU 推理等方向让 LLM 从云端走向边缘:
挑战:
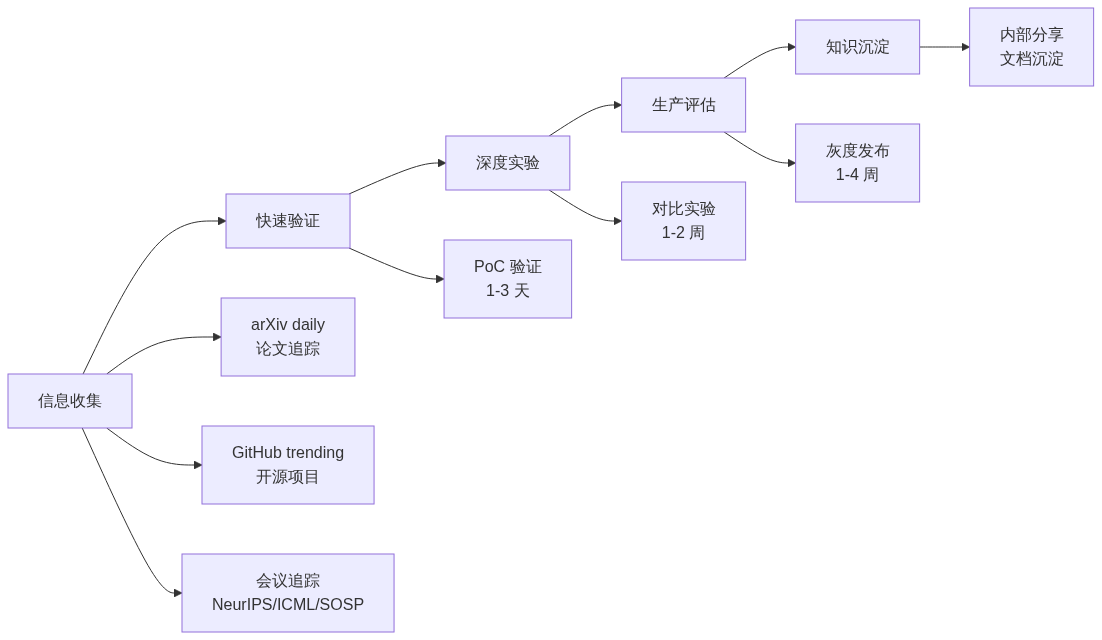
如何保持技术敏感度
信息来源推荐
技术评估 Checklist
在评估一项新技术时,回答以下问题:
面试视角
面试官可能问:
"最近 LLM 推理领域有什么值得关注的新方向?"
2. "这些新技术你怎么评估?"
3. "你怎么保持技术更新?"
4. "这些技术在实际生产中有什么限制?"
5. "你会优先考虑引入哪项技术?"
部署视角
技术成熟度分级(2026 年中)
最佳实践
 学习助手