LLM 推理服务的容灾不只是"备用服务器",还涉及 GPU 硬件故障、模型权重损坏、显存泄漏等特有风险,需要分层次的防御体系。
核心概念(含架构图)
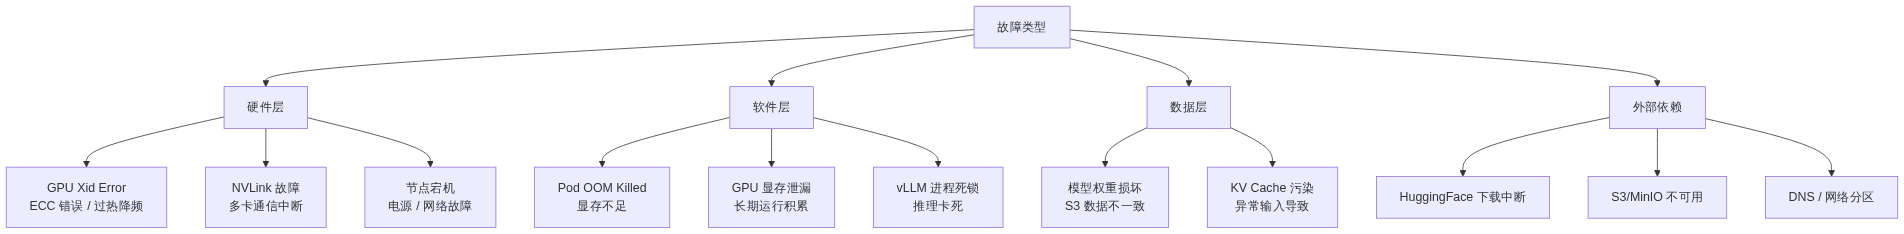
故障场景全景分析
部署视角
GPU 故障处理(Xid Error 检测与自动隔离)
Xid Error 类型
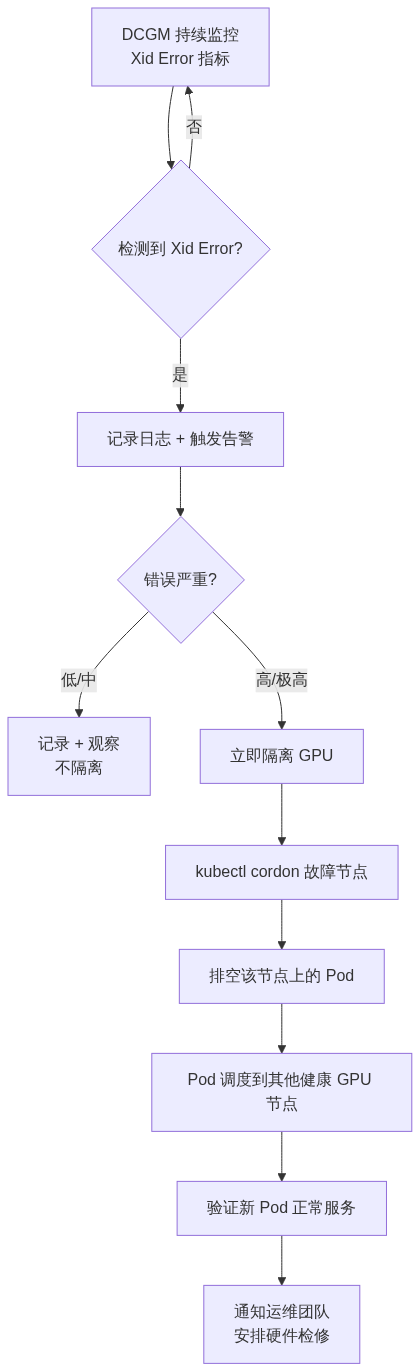
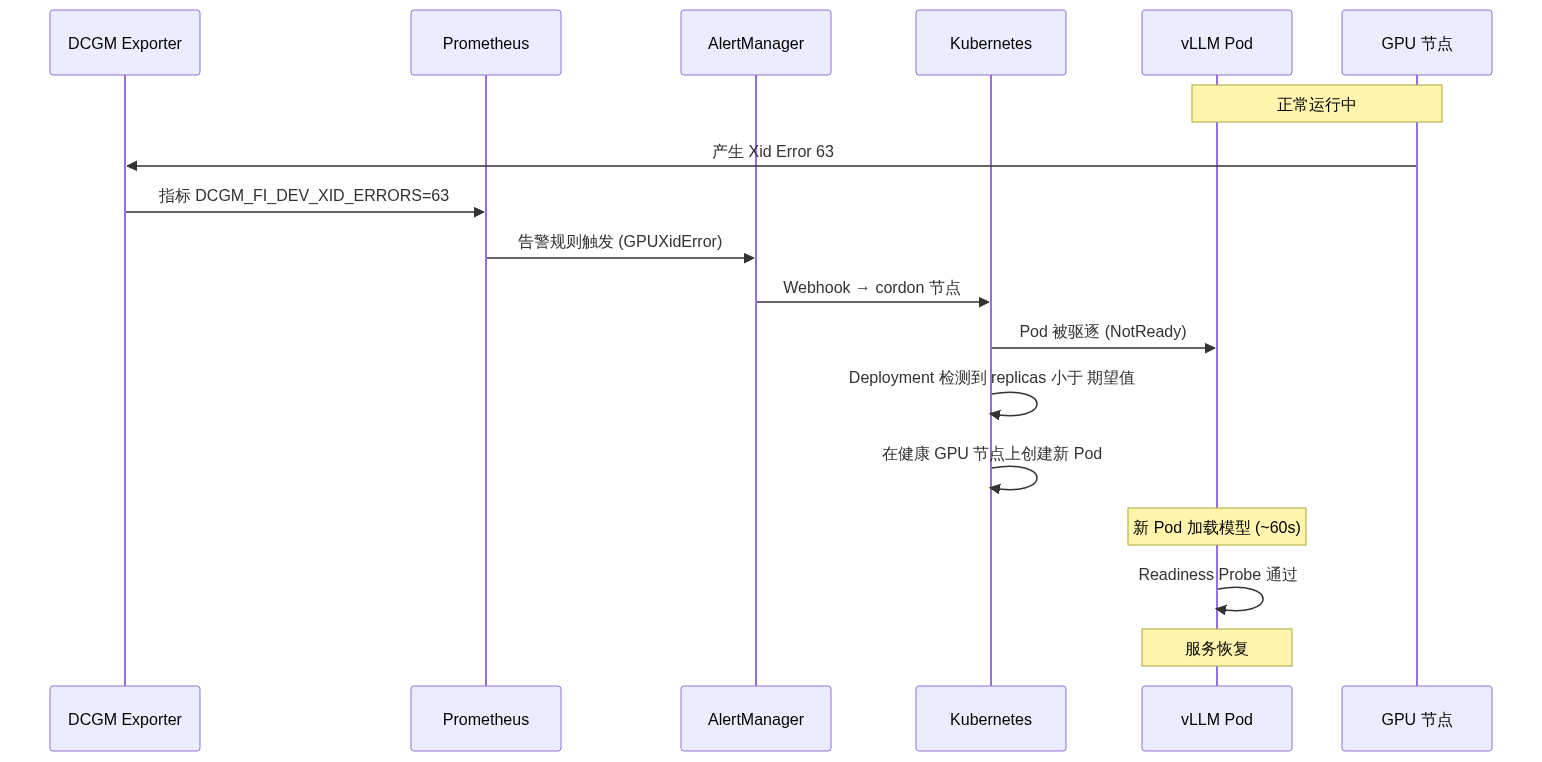
自动检测与隔离流程
# 自动化脚本:Xid Error 检测 + 节点隔离import subprocessimport jsondef check_gpu_health(): """通过 DCGM 检查 GPU 健康状态""" result = subprocess.run( ['dcgmi', 'diag', '-r', '1', '-j'], capture_output=True, text=True ) diagnostics = json.loads(result.stdout) for gpu_id, diag in diagnostics.items(): if diag.get('error_count', 0) > 0: xid_errors = diag.get('xid_errors', []) for err in xid_errors: if err['xid'] in [13, 31, 43, 63, 79]: isolate_gpu(gpu_id, err['xid'])def isolate_gpu(gpu_id, xid): """隔离故障 GPU 所在节点""" node = get_node_for_gpu(gpu_id) # 1. 标记节点不可调度 subprocess.run(['kubectl', 'cordon', node]) # 2. 排空 Pod subprocess.run(['kubectl', 'drain', node, '--ignore-daemonsets', '--delete-emptydir-data', '--grace-period=120']) # 3. 发送告警 send_alert(f"GPU {gpu_id} on {node} Xid={xid}, node cordoned")
Kubernetes 侧实现(Node Problem Detector + 自动恢复)
# Node Problem Detector:自动将不健康的 GPU 节点标记为 NotReadyapiVersion: apps/v1kind: DaemonSetmetadata: name: node-problem-detector namespace: kube-systemspec: template: spec: containers: - name: node-problem-detector image: registry.k8s.io/node-problem-detector/node-problem-detector:v0.8.14 env: - name: CUSTOM_PLUGINS value: | # 自定义 GPU 健康检查插件 # 当检测到 Xid Error 时,向 K8s 报告 Condition---# 自动恢复:GPU 故障后 Pod 自动调度到健康节点apiVersion: apps/v1kind: Deploymentspec: template: spec: # 容忍短暂的 NotReady 状态,给节点恢复时间 tolerations: - key: "node.kubernetes.io/not-ready" operator: "Exists" effect: "NoExecute" timeoutSeconds: 60 # 60 秒后 K8s 自动迁移 Pod affinity: podAntiAffinity: requiredDuringSchedulingIgnoredDuringExecution: - labelSelector: matchExpressions: - key: app operator: In values: ["vllm"] topologyKey: "kubernetes.io/hostname"
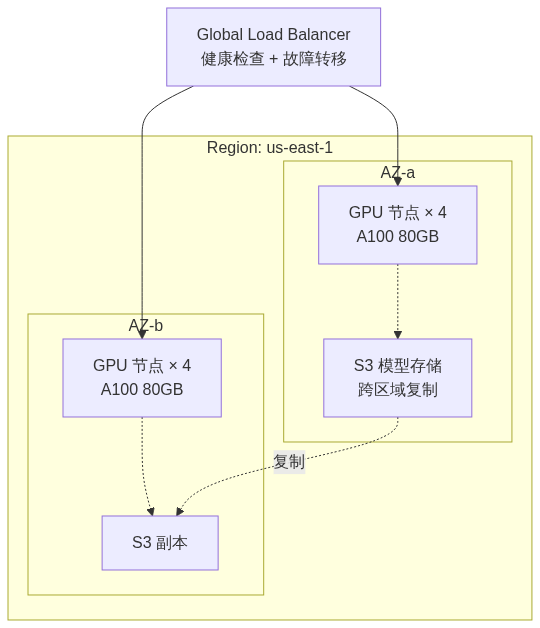
容灾策略:多 AZ 部署
多 AZ 部署要点:
# Pod 拓扑分布约束:确保跨 AZ 均匀分布topologySpreadConstraints:- maxSkew: 1 topologyKey: topology.kubernetes.io/zone whenUnsatisfiable: DoNotSchedule labelSelector: matchLabels: app: vllm
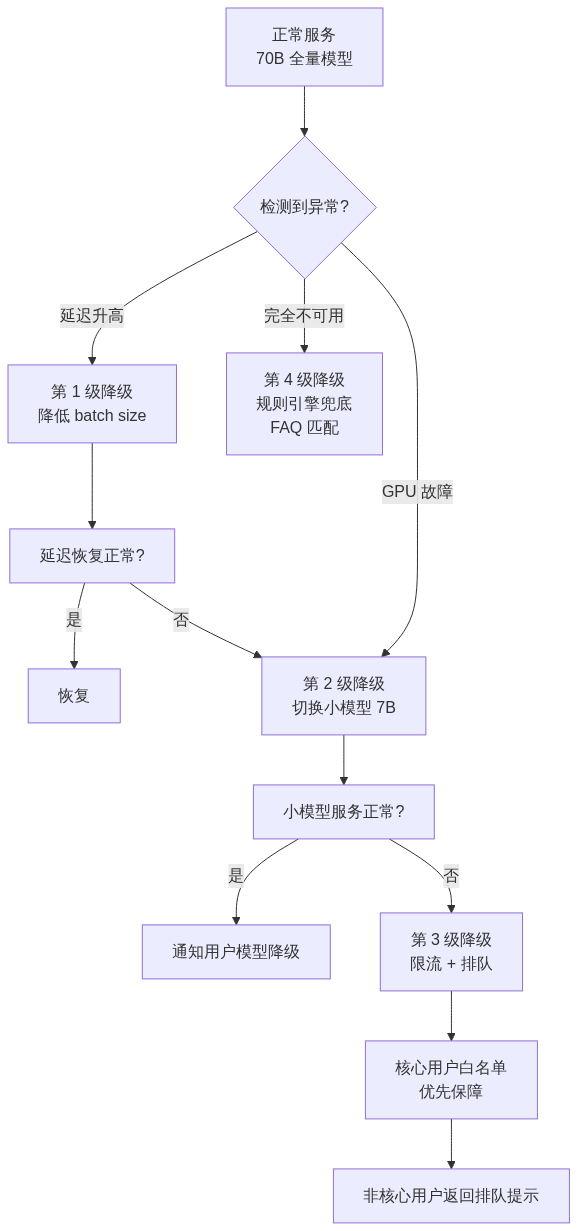
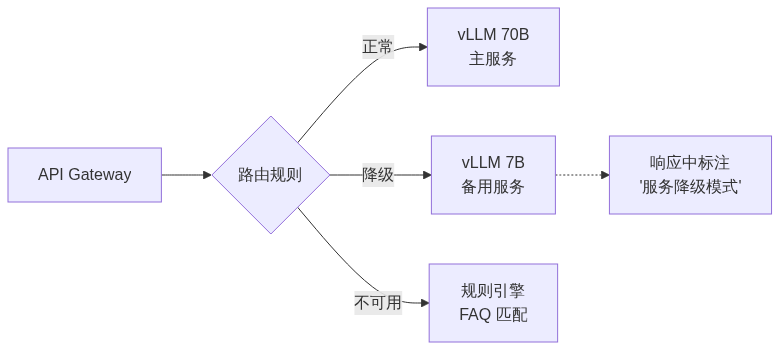
降级策略详解
各级降级详细说明:
第 1 级:降低 Batch Size
# 通过 ConfigMap 热更新 vLLM 配置# max-num-seqs: 256 → 64# 效果:单请求延迟降低,总吞吐下降# 适用:延迟升高但 GPU 仍有能力
第 2 级:切换小模型
# API Gateway 降级路由# 正常路由- match: { prefix: "/v1/chat/completions" } route: { cluster: vllm-70b }# 降级路由(通过 feature flag 切换)# - match: { prefix: "/v1/chat/completions" }# route: { cluster: vllm-7b }
第 3 级:限流 + 排队
# Token Bucket 限流(API Gateway 层)# 核心用户:100 req/min# 普通用户:10 req/min# 降级期间:核心用户 50 req/min, 普通用户 2 req/min# 排队响应{ "status": "queued", "position": 15, "estimated_wait_seconds": 45, "task_id": "task-xyz789", "poll_url": "/v1/tasks/task-xyz789/status"}
数据恢复与模型回滚
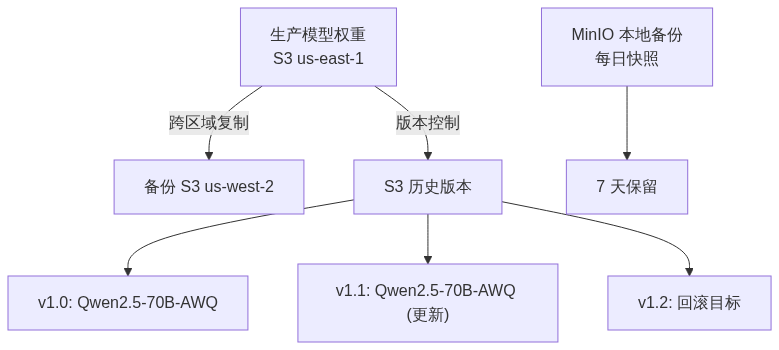
模型权重备份策略
关键措施:
模型回滚流程
# 回滚命令(K8s 原生支持)kubectl rollout undo deployment/vllm-llm --to-revision=2# 回滚到第 2 个版本(即上一版本)# 回滚验证# 1. 检查新 Pod 状态: kubectl get pods -l app=vllm# 2. 验证健康: curl http://vllm-service/health# 3. 冒烟测试: 发几个标准 prompt 验证输出# 4. 监控 SLO: 确认延迟恢复正常
面试视角
面试题:GPU 故障导致 Pod 崩溃,如何自动恢复?
标准答案:
完整自动恢复链:
如果只有有限 GPU 资源无法调度怎么办?
常见追问
Q: GPU 显存泄漏如何检测和处理?
A:
Q: 多 AZ 部署时模型权重如何保证一致性?
Q: 如何避免降级期间的"降级雪崩"(小模型也被压垮)?
 学习助手