没有可观测性的 LLM 服务就像在黑暗中开飞机,你不知道什么时候会坠毁。LLM 推理的可观测性需要覆盖 GPU 硬件、推理引擎、业务指标三个层次。
核心概念(含架构图)
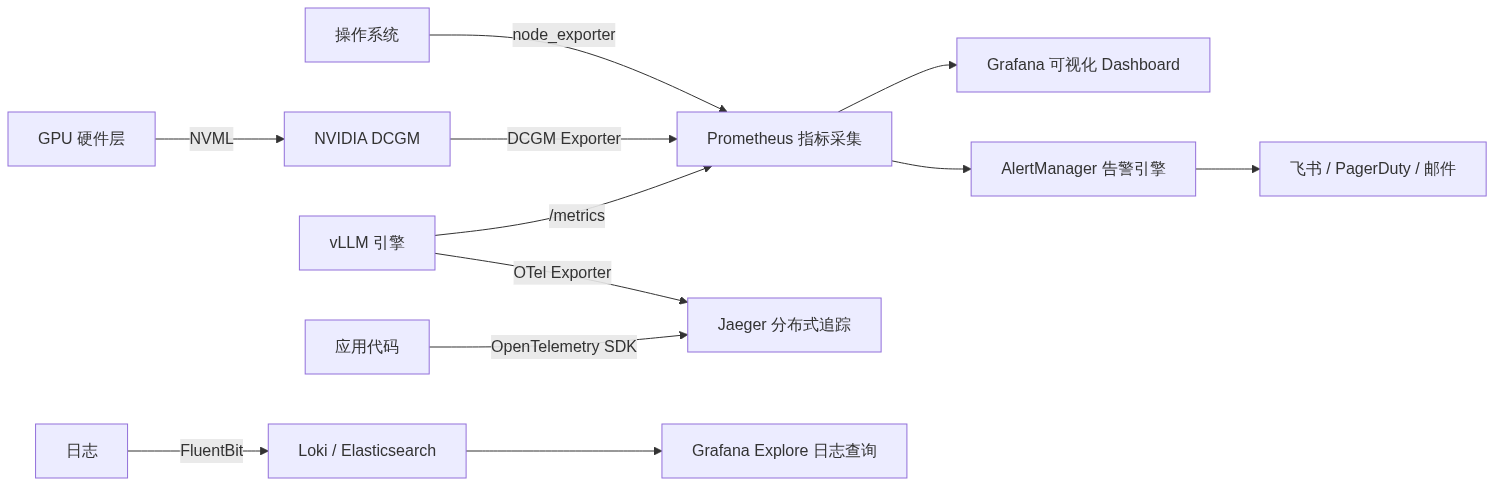
监控数据流全景
可观测性的三个层次
三者关系:AlertManager 基于 Metrics 触发告警,查看 Grafana Dashboard 定位异常指标,在 Jaeger 中追踪慢请求的完整链路,在 Loki 中查看具体日志条目。
部署视角
LLM 推理关键监控指标
1. 延迟指标(Latency)
TTFT(Time To First Token): 用户发出请求到收到第一个 token 的时间
TPOT(Time Per Output Token): 每个 token 生成的平均时间
End-to-End Latency: 从请求发出到完整响应完成的总时间
# Prometheus 中记录延迟的 Histogram 配置# 在 vLLM 指标中自动暴露# vllm_e2e_request_latency_seconds_bucket# vllm_time_to_first_token_seconds_bucket# vllm_time_per_output_token_seconds_bucket# Grafana 面板中计算 P99:# histogram_quantile(0.99, rate(vllm_time_to_first_token_seconds_bucket[5m]))
2. 吞吐指标(Throughput)
3. GPU 硬件指标
4. 应用层指标
Prometheus + Grafana 部署方案
Prometheus 配置
# prometheus-values.yamlserver: global: scrape_interval: 15s evaluation_interval: 15s extraScrapeConfigs: | # 采集 vLLM 指标 - job_name: 'vllm' kubernetes_sd_configs: - role: pod relabel_configs: - source_labels: [__meta_kubernetes_pod_label_app] action: keep regex: vllm - source_labels: [__address__] action: replace regex: (.+):8000 replacement: ${1}:8000 target_label: __address__ metrics_path: /metrics # 采集 NVIDIA DCGM 指标 - job_name: 'dcgm' kubernetes_sd_configs: - role: pod relabel_configs: - source_labels: [__meta_kubernetes_pod_label_app] action: keep regex: dcgm-exporter metrics_path: /metrics # 采集 K8s 节点指标 - job_name: 'node-exporter' kubernetes_sd_configs: - role: pod relabel_configs: - source_labels: [__meta_kubernetes_pod_label_app_kubernetes_io_name] action: keep regex: node-exporter
Grafana Dashboard 核心面板
{ "dashboard": { "title": "LLM Inference Service", "panels": [ { "title": "P99 TTFT", "targets": [{ "expr": "histogram_quantile(0.99, rate(vllm_time_to_first_token_seconds_bucket[5m]))" }], "thresholds": [ {"value": 0.4, "color": "yellow"}, {"value": 0.8, "color": "red"} ] }, { "title": "GPU Utilization", "targets": [{ "expr": "avg(DCGM_FI_DEV_GPU_UTIL) by (gpu)" }] }, { "title": "GPU Memory Usage", "targets": [{ "expr": "DCGM_FI_DEV_FB_USED / (DCGM_FI_DEV_FB_USED + DCGM_FI_DEV_FB_FREE) * 100" }] }, { "title": "Request Queue Length", "targets": [{ "expr": "sum(vllm_num_requests_waiting)" }], "thresholds": [ {"value": 10, "color": "yellow"}, {"value": 50, "color": "red"} ] }, { "title": "Tokens/sec per GPU", "targets": [{ "expr": "rate(vllm_generation_tokens_total[1m])" }] } ] }}
Distributed Tracing(OpenTelemetry + Jaeger)
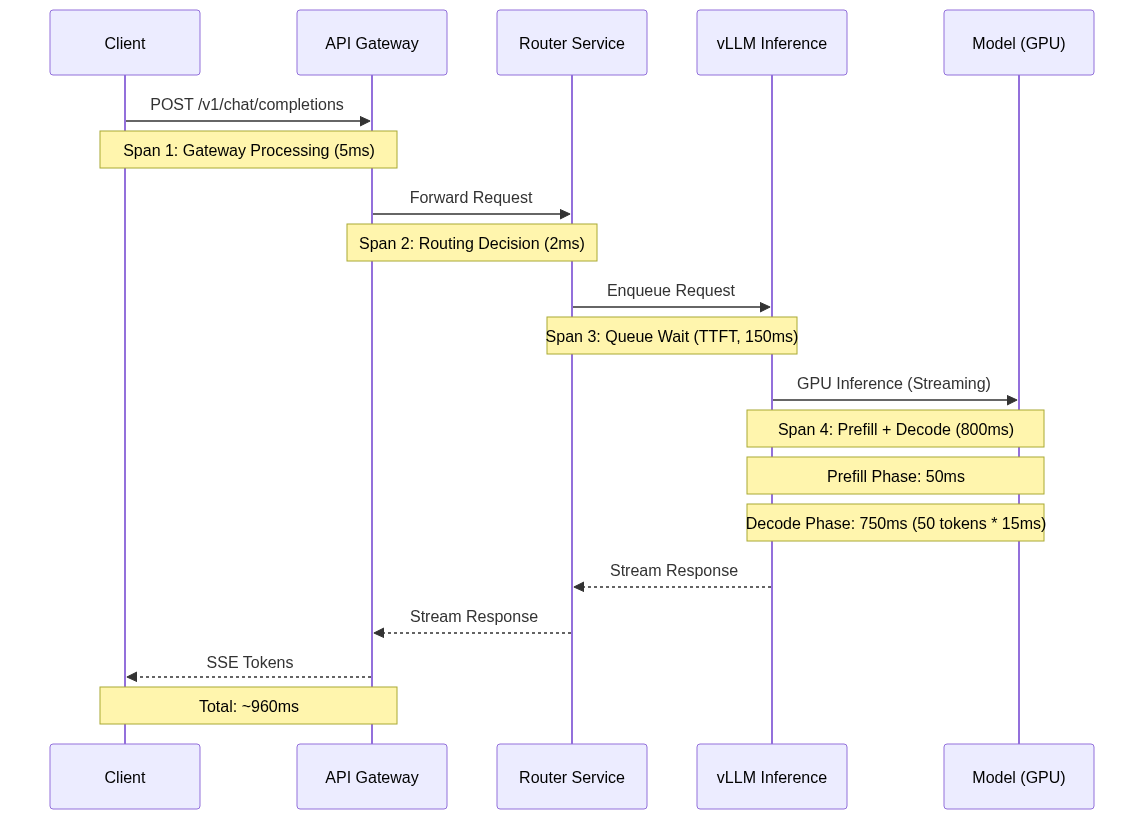
链路追踪在推理服务中的价值
LLM 请求的完整链路:
OpenTelemetry 集成
# vLLM 启用 OpenTelemetry(vLLM 内置支持)from vllm.entrypoints.openai.api_server import appfrom opentelemetry import tracefrom opentelemetry.sdk.trace import TracerProviderfrom opentelemetry.exporter.jaeger.thrift import JaegerExportertrace.set_tracer_provider(TracerProvider())trace.get_tracer_provider().add_span_processor( BatchSpanProcessor( JaegerExporter( agent_host_name="jaeger-collector.monitoring", agent_port=6831, ) ))# 关键 Span 定义# - vllm.handle_request: 完整请求处理# - vllm.scheduler.schedule: 调度决策# - vllm.worker.execute_model: GPU 推理# - vllm.engine.add_request: 请求入队
日志收集(EFK / Loki)
Loki 方案(轻量级,与 Grafana 原生集成)
# loki-values.yamlloki: config: limits_config: max_line_size: 65536 # 单行最大 64KB(适应长 prompt) max_query_series: 1000 schema_config: configs: - from: 2024-01-01 store: boltdb-shipper object_store: s3 schema: v12 index: prefix: loki_index_ period: 24h# Promtail / FluentBit 采集配置fluent-bit: config: service: | [SERVICE] Flush 1 Log_Level info pipeline: | [INPUT] Name tail Path /var/log/containers/*vllm*.log Parser docker Tag kube.* Mem_Buf_Limit 50MB [FILTER] Name kubernetes Match kube.* [OUTPUT] Name loki Match kube.* Host loki.monitoring Port 3100
结构化日志关键字段
{ "timestamp": "2026-05-11T10:30:45.123Z", "level": "info", "service": "vllm", "pod": "vllm-llm-5d8f7b6c4-xk9m2", "model": "Qwen2.5-72B-Instruct-AWQ", "request_id": "req-abc123", "trace_id": "0123456789abcdef", "event": "request_completed", "prompt_tokens": 512, "completion_tokens": 256, "ttft_ms": 145, "total_latency_ms": 2340, "gpu_id": 0, "status": "success"}
告警规则设计
# alertmanager-rules.yamlgroups:- name: llm-inference rules: # 1. 延迟告警(最核心) - alert: HighTTFTP99 expr: histogram_quantile(0.99, rate(vllm_time_to_first_token_seconds_bucket[5m])) > 0.8 for: 2m labels: severity: warning annotations: summary: "TTFT P99 过高 ({{ $value | humanizeDuration }})" description: "用户感知明显延迟,检查 GPU 利用率和队列长度" - alert: CriticalTTFTP99 expr: histogram_quantile(0.99, rate(vllm_time_to_first_token_seconds_bucket[2m])) > 2.0 for: 1m labels: severity: critical annotations: summary: "TTFT P99 严重超标" description: "服务可能异常,立即排查" # 2. GPU OOM 告警 - alert: GPUMemoryNearFull expr: DCGM_FI_DEV_FB_USED / (DCGM_FI_DEV_FB_USED + DCGM_FI_DEV_FB_FREE) * 100 > 95 for: 1m labels: severity: critical annotations: summary: "GPU 显存即将耗尽 ({{ $value }}%)" description: "Pod {{ $labels.pod }} GPU {{ $labels.gpu }} 显存使用率超过 95%" # 3. GPU 温度告警 - alert: GPUTemperatureHigh expr: DCGM_FI_DEV_GPU_TEMP > 85 for: 5m labels: severity: warning annotations: summary: "GPU 温度过高 ({{ $value }} 摄氏度)" # 4. GPU 硬件错误告警 - alert: GPUXidError expr: increase(DCGM_FI_DEV_XID_ERRORS[5m]) > 0 for: 0m labels: severity: critical annotations: summary: "GPU Xid Error 检测" description: "GPU {{ $labels.gpu }} 发生硬件级错误 Xid={{ $value }}" # 5. 请求队列堆积 - alert: RequestQueueBuilding expr: sum(vllm_num_requests_waiting) > 50 for: 3m labels: severity: warning annotations: summary: "请求队列堆积 ({{ $value }} 个请求排队)" # 6. 错误率告警 - alert: HighErrorRate expr: | sum(rate(vllm_request_success_total{status="error"}[5m])) / sum(rate(vllm_request_success_total[5m])) > 0.05 for: 2m labels: severity: critical annotations: summary: "请求错误率超过 5%" # 7. KV Cache 饱和 - alert: KVCacheSaturation expr: avg(vllm_gpu_cache_usage_perc) > 0.9 for: 2m labels: severity: warning annotations: summary: "KV Cache 使用率超过 90%"
面试视角
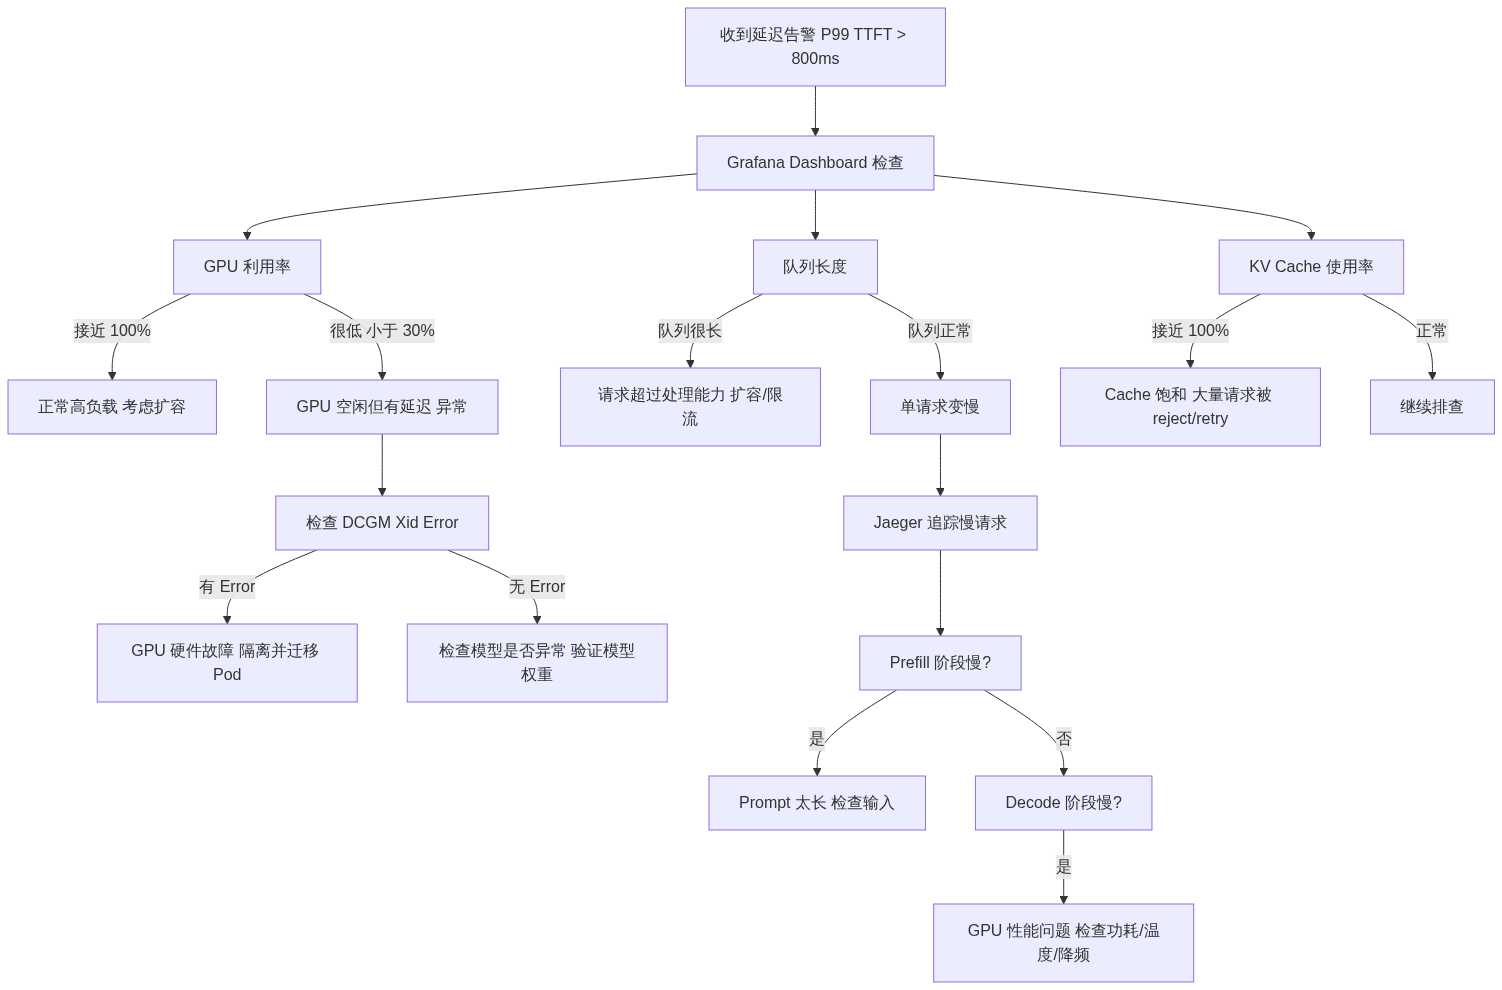
面试题:线上推理延迟突然升高,怎么排查?
标准排查路径(5 分钟内定位问题):
详细排查步骤:
常见根因:
面试进阶问题
最佳实践
 学习助手