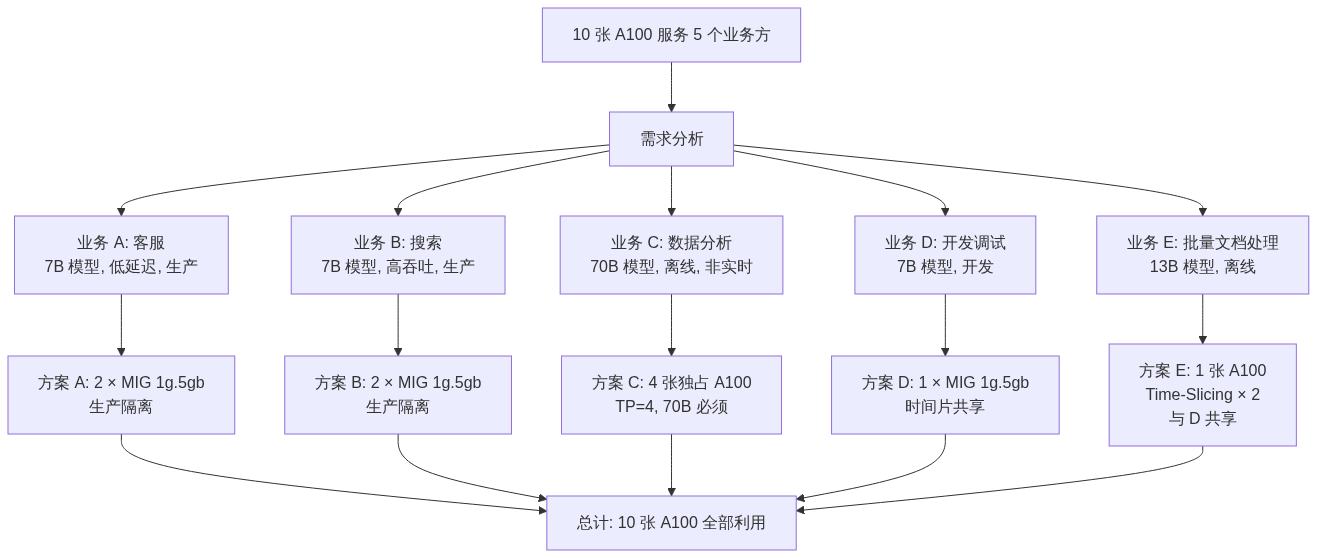
多租户是 LLM 推理平台化的核心挑战:如何在有限的 GPU 上安全、公平、可计量地服务多个业务方,是 FDE 面试中的高频场景。
核心概念(含架构图)
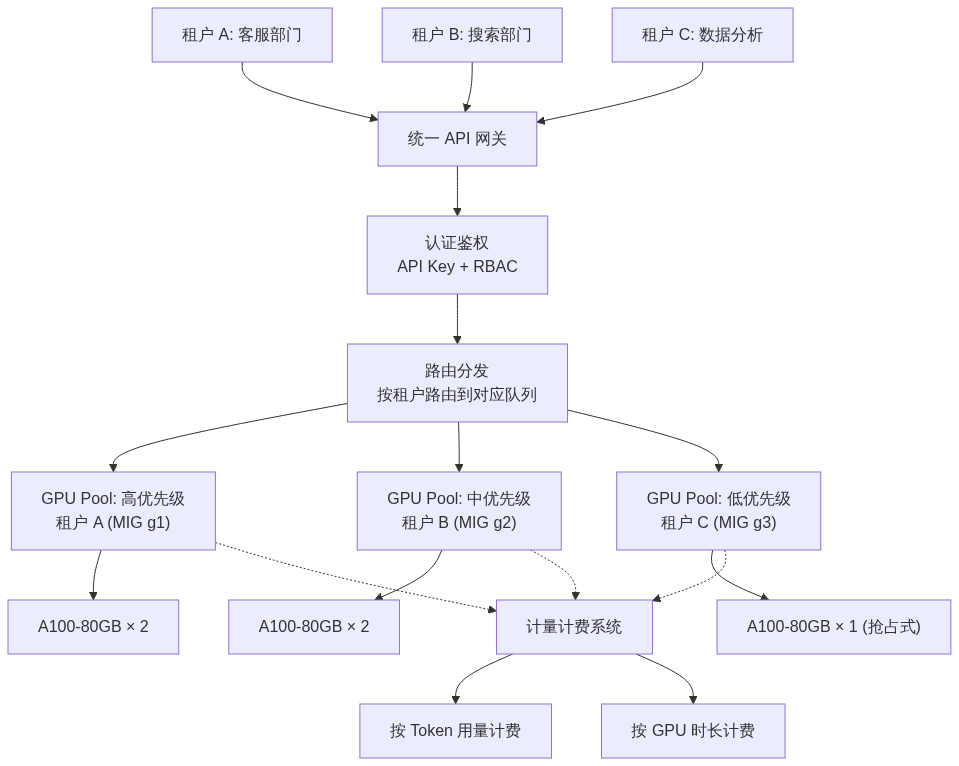
多租户推理平台架构
部署视角
资源隔离策略对比
Kubernetes Namespace + ResourceQuota 隔离
# 为每个租户创建独立 NamespaceapiVersion: v1kind: Namespacemetadata: name: tenant-customer-service labels: tenant: customer-service team: support---# ResourceQuota:限制租户可使用的资源总量apiVersion: v1kind: ResourceQuotametadata: name: gpu-quota namespace: tenant-customer-servicespec: hard: requests.nvidia.com/gpu: "4" # 最多申请 4 张 GPU limits.nvidia.com/gpu: "4" requests.memory: "256Gi" limits.memory: "256Gi" requests.cpu: "32" limits.cpu: "32" pods: "20" # 最多 20 个 Pod---# LimitRange:限制单个容器的资源范围apiVersion: v1kind: LimitRangemetadata: name: gpu-limit-range namespace: tenant-customer-servicespec: limits: - type: Container default: # 默认限制 nvidia.com/gpu: "1" memory: "64Gi" cpu: "8" defaultRequest: nvidia.com/gpu: "1" memory: "32Gi" cpu: "4" max: # 单个容器不能超过 nvidia.com/gpu: "4" memory: "128Gi" min: nvidia.com/gpu: "1"
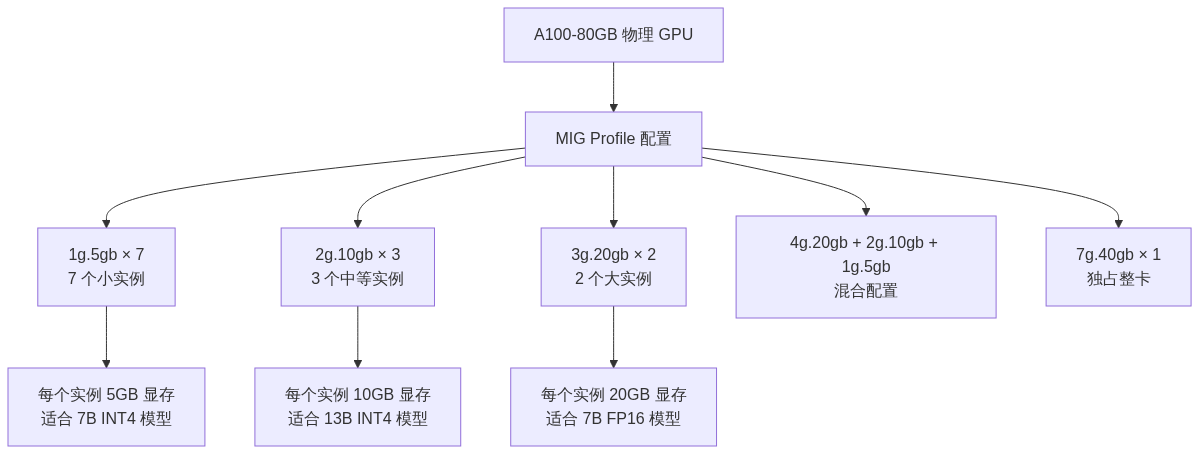
MIG(Multi-Instance GPU)详解
什么是 MIG?
NVIDIA A100/H100 支持将一张物理 GPU 切分为最多 7 个独立的 MIG 实例,每个实例拥有独立的:
MIG 配置示例
# 1. 启用 MIG 模式nvidia-smi -mig 1# 2. 查看支持的 MIG Profilenvidia-smi mig -lgip# 3. 创建 MIG 实例(例如 2 个 3g.20gb 实例)nvidia-smi mig -cgi 3g.20gb -C 2# 4. 创建 GPU Instance 后,再创建 Compute Instancenvidia-smi mig -lgi # 查看 GPU Instancenvidia-smi mig -cci -gi <GI_ID> # 创建 Compute Instance# 5. 验证 MIG 实例nvidia-smi# +-----------------------------------------------------------------------------+# | MIG devices: |# | GPU GI CI Memory GPU SM DEC ENC OFA ECC Compute Mode |# | 0 0 0 20.0GiB 40 28 2 1 1 On Default |# | 0 1 0 20.0GiB 40 28 2 1 1 On Default |# +-----------------------------------------------------------------------------+
K8s 中使用 MIG
# 安装 NVIDIA GPU Operator(自动管理 MIG)helm install gpu-operator nvidia/gpu-operator \ --namespace gpu-operator \ --create-namespace \ --set mig.strategy=single # single 或 mixed# Pod 申请 MIG 实例apiVersion: v1kind: Podmetadata: name: tenant-a-llm namespace: tenant-customer-servicespec: containers: - name: vllm image: vllm/vllm-openai:latest resources: limits: # 申请一个 3g.20gb 的 MIG 实例 nvidia.com/mig-3g.20gb: 1 requests: nvidia.com/mig-3g.20gb: 1
MIG 适用场景
MIG 限制:
GPU 时间片分片(Time-Slicing)
# GPU Time-Slicing:多租户共享一张 GPU,时间片轮转# 通过 NVIDIA GPU Operator 配置apiVersion: v1kind: ConfigMapmetadata: name: time-slicing-config namespace: gpu-operatordata: any: | version: v1 flags: migStrategy: none sharing: timeSlicing: resources: - name: nvidia.com/gpu replicas: 4 # 一张 GPU 虚拟化为 4 个共享设备---# 4 个 Pod 可以同时申请 nvidia.com/gpu: 1# 但实际上共享一张物理卡,时间片轮转# 适合:开发、测试、低负载推理
时间片 vs MIG 对比:
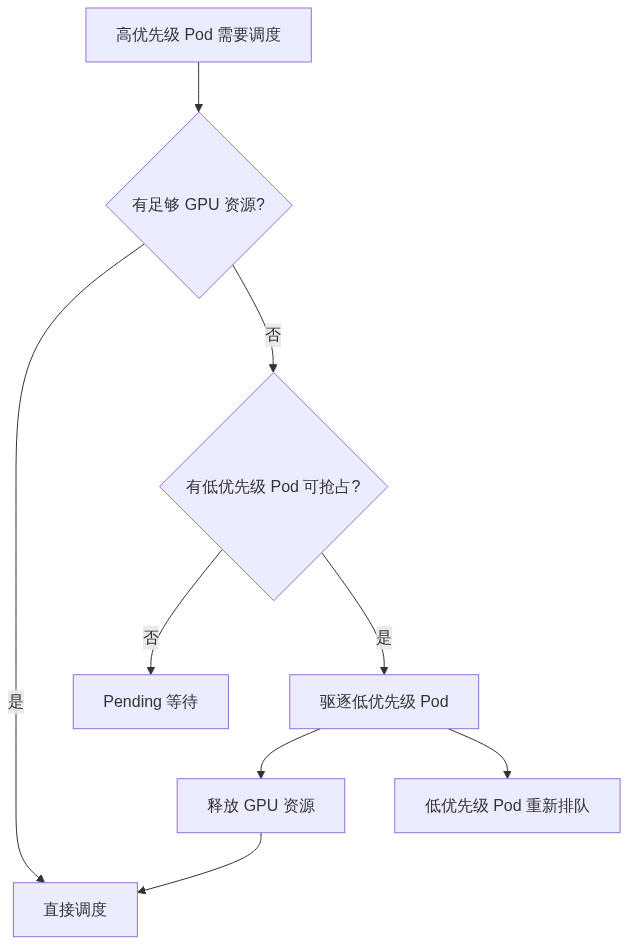
优先级队列与抢占调度
# PriorityClass 定义apiVersion: scheduling.k8s.io/v1kind: PriorityClassmetadata: name: tenant-criticalvalue: 1000000 # 最高优先级globalDefault: falsedescription: "核心业务租户,不可抢占"---apiVersion: scheduling.k8s.io/v1kind: PriorityClassmetadata: name: tenant-normalvalue: 500000 # 中等优先级globalDefault: truedescription: "普通业务租户"---apiVersion: scheduling.k8s.io/v1kind: PriorityClassmetadata: name: tenant-batchvalue: 100000 # 低优先级globalDefault: falsedescription: "批量任务/离线推理,可被抢占"
Pod 抢占流程:
# 高优先级 Pod(可抢占其他 Pod)spec: priorityClassName: tenant-critical preemptionPolicy: PreemptLowerPriority # 默认值# 低优先级 Pod(标记为可被抢占)spec: priorityClassName: tenant-batch # 当高优先级 Pod 需要资源时,此 Pod 会被优雅驱逐 # terminationGracePeriodSeconds 控制等待时间
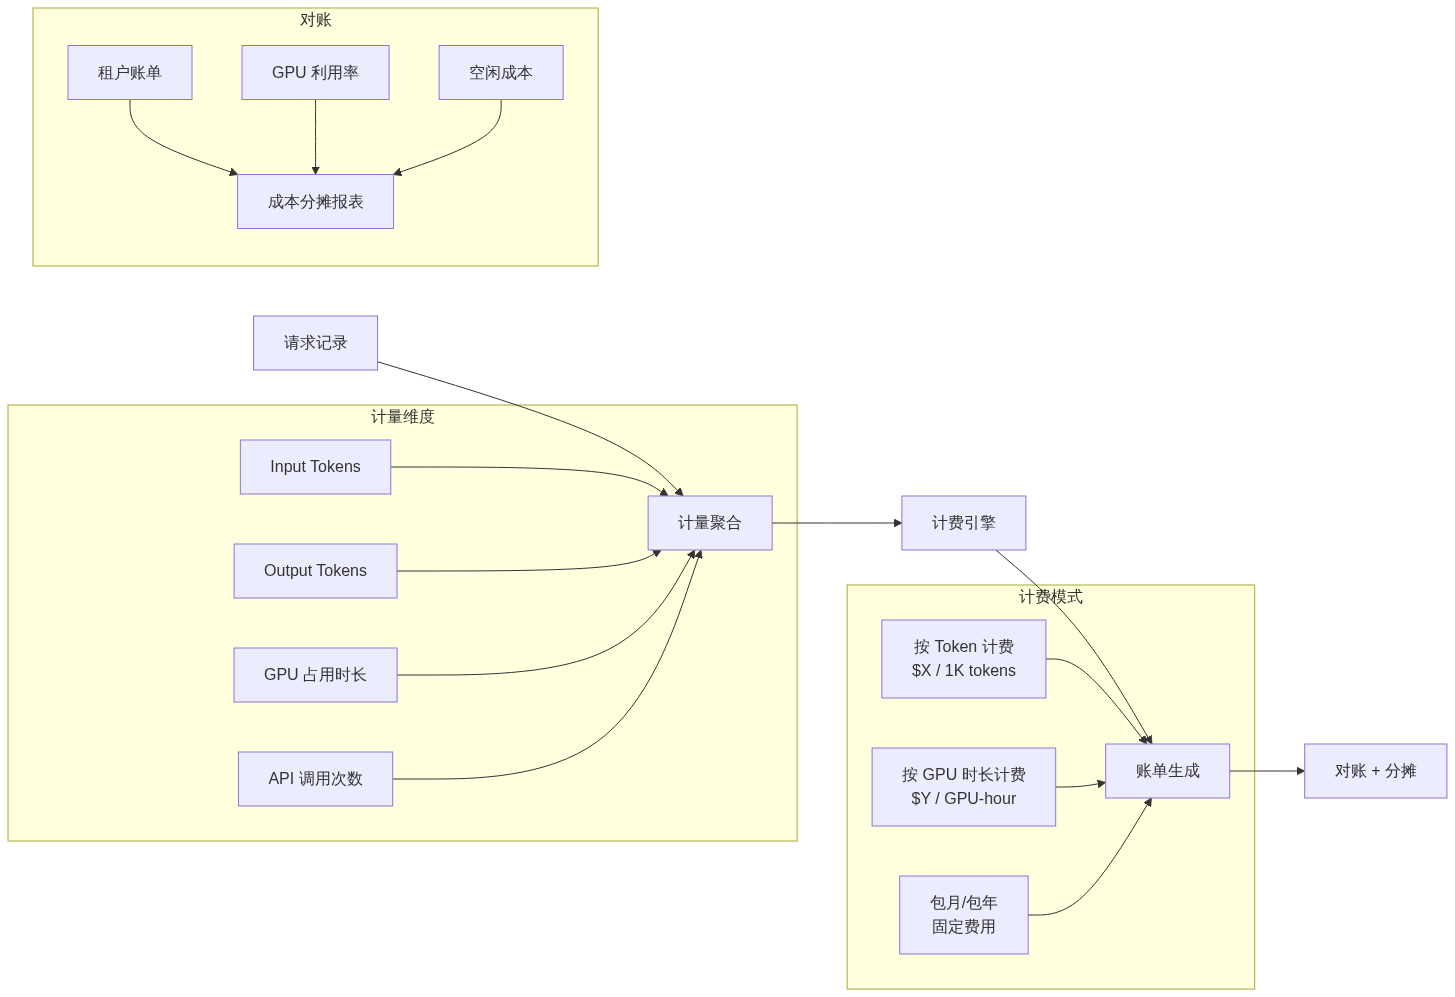
计费与对账
计费模型设计
计费指标采集:
# vLLM Prometheus 指标# 每个租户的请求统计vllm_request_total{tenant="customer-service",model="qwen2.5-7b"}vllm_request_success_total{tenant="customer-service"}vllm_prompt_tokens_total{tenant="customer-service"}vllm_generation_tokens_total{tenant="customer-service"}# 计费 SQL 示例(从 Prometheus 查询)# 租户 A 本月费用 = Input Tokens × $0.001/1K + Output Tokens × $0.003/1K# + GPU 占用时长(h) × $5/h
对账关键字段:
安全与权限隔离
# NetworkPolicy:租户间网络隔离apiVersion: networking.k8s.io/v1kind: NetworkPolicymetadata: name: tenant-isolation namespace: tenant-customer-servicespec: podSelector: matchLabels: app: vllm policyTypes: - Ingress - Egress ingress: # 只允许 API Gateway 访问 - from: - namespaceSelector: matchLabels: name: api-gateway ports: - protocol: TCP port: 8000 egress: # 只允许访问模型存储和监控 - to: - namespaceSelector: matchLabels: name: monitoring - namespaceSelector: matchLabels: name: model-registry
安全隔离清单:
面试视角
面试题:如何在有限的 GPU 上服务多个业务方?
标准答案(分层策略):
详细策略:
# 弹性配额(ClusterResourceQuota 或 Kueue)# 保证配额 + 借用额度apiVersion: kueue.x-k8s.io/v1beta1kind: ResourceFlavormetadata: name: a100-80gb---apiVersion: kueue.x-k8s.io/v1beta1kind: ClusterQueuemetadata: name: tenant-customer-servicespec: namespaceSelector: matchLabels: tenant: customer-service resourceGroups: - coveredResources: ["nvidia.com/gpu"] flavors: - name: a100-80gb resources: - name: "nvidia.com/gpu" nominalQuota: 2 # 保证 2 张 GPU borrowingLimit: 2 # 最多借用 2 张 lendingLimit: 0 # 不借出给别人
常见追问
Q: MIG 和 Time-Slicing 如何选择?
A:
Q: 如何防止某个租户的异常请求影响其他租户?
Q: 多租户场景如何做容量规划?
 学习助手