RAG(检索增强生成)是企业在生产环境中最常用的 AI 架构——它不需要训练模型,就能让 LLM 基于私有知识给出准确回答。
前置知识
什么是 RAG
RAG = R etrieval(检索)+ A ugmented(增强)+ G eneration(生成)
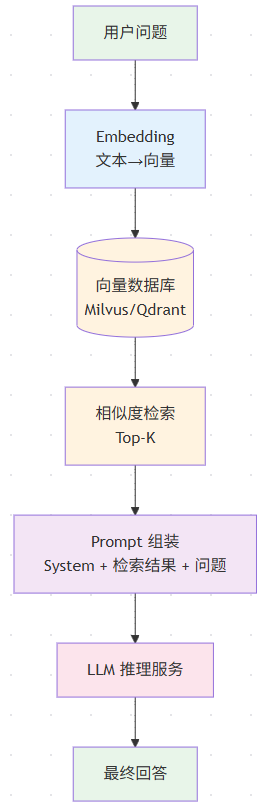
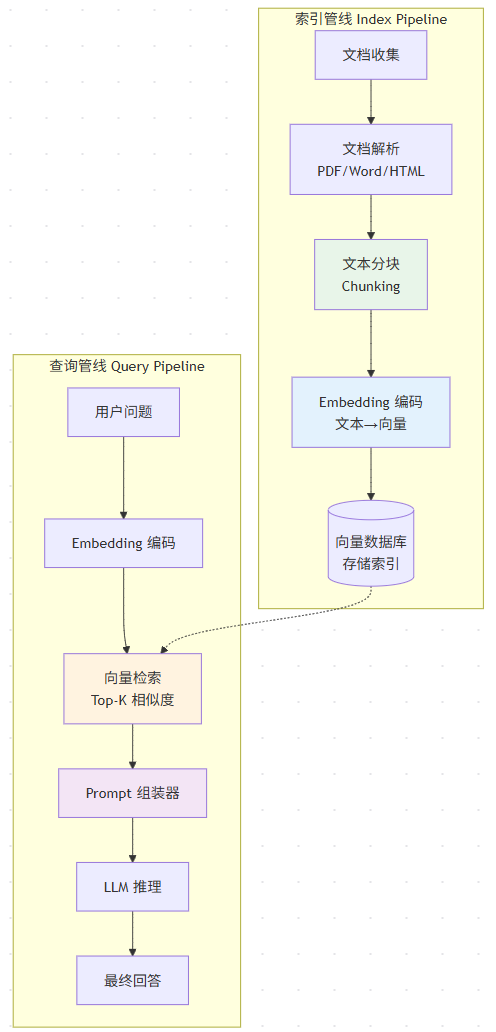
核心思路: 先检索,再生成 ——从外部知识库中找到与用户问题最相关的信息,拼接到 Prompt 中,让 LLM 基于这些信息生成回答。
为什么需要 RAG?
一行话: RAG 让 LLM 不用训练就能"读"你的私有文档。
RAG 核心组件拆解
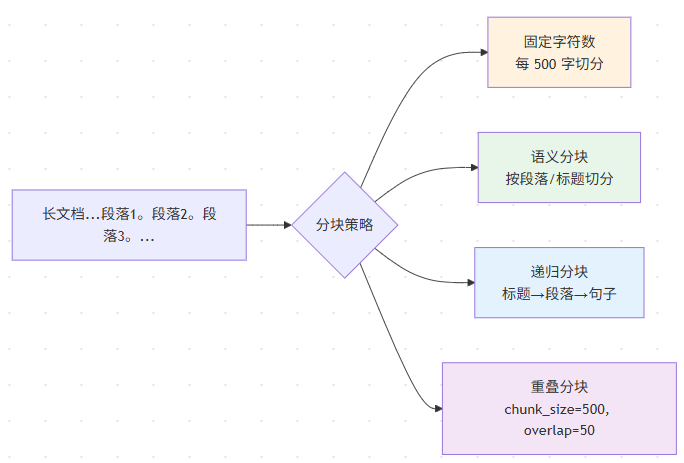
1. 文档分块(Chunking)
分块策略直接影响检索质量。
Chunk Size 的 trade-off:
Chunk 太小 → 信息不完整,检索不到关键内容Chunk 太大 → 引入噪声,浪费 Prompt token,LLM 注意力分散经验值:- 技术文档:500-800 tokens- 对话记录:200-400 tokens- 法律合同:300-600 tokens- 代码文件:按函数/类切分
2. Embedding 模型选型
选择建议:
3. 向量数据库选型
# 常用相似度算法import numpy as npdef cosine_similarity(a: np.ndarray, b: np.ndarray) -> float: """余弦相似度 — 最常用,衡量方向差异""" return np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b))def dot_product(a: np.ndarray, b: np.ndarray) -> float: """点积 — OpenAI embedding 推荐""" return np.dot(a, b)def euclidean_distance(a: np.ndarray, b: np.ndarray) -> float: """欧氏距离 — 衡量绝对距离""" return np.linalg.norm(a - b)
4. 相似度度量
高级 RAG 技术
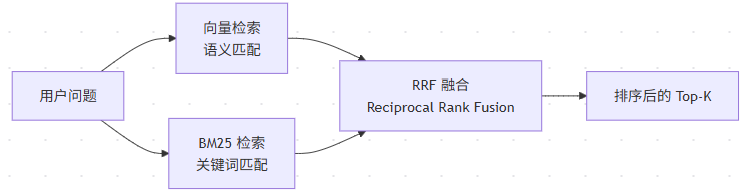
1. 混合检索(Hybrid Search)
向量检索擅长语义理解,但可能漏掉关键词精确匹配的结果。混合检索 = 向量检索 + BM25 关键词检索。
RRF(Reciprocal Rank Fusion)公式:
RRF(d) = Σ 1 / (k + rank(d))其中 k = 60(经验值),rank(d) 是文档在某个检索结果中的排名示例:文档 A:向量检索排第 1,BM25 排第 5RRF(A) = 1/(60+1) + 1/(60+5) = 0.0164 + 0.0154 = 0.0318文档 B:向量检索排第 3,BM25 排第 2RRF(B) = 1/(60+3) + 1/(60+2) = 0.0159 + 0.0161 = 0.0320→ B 排前面
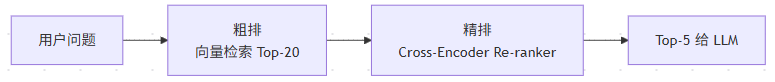
2. 重排序(Re-ranking)
向量检索(双塔模型)是近似相似度,Cross-Encoder Re-ranker 会把 query 和 document 一起输入模型做精确打分。
常用 Re-ranker:
Re-ranker 的 trade-off:
不加 Re-ranker: 延迟:低(只走一次向量检索) 准确率:中等 适用:对延迟敏感的场景加 Re-ranker: 延迟:+50-200ms(需要额外推理) 准确率:显著提升(MRR +10-30%) 适用:对准确率要求高的场景
3. 上下文压缩(Context Compression)
检索到的上下文可能包含大量无关信息,需要压缩:
# 上下文压缩的三种方式# 1. 句子级别过滤 — 只保留与问题相关的句子def sentence_filter(sentences: list[str], query: str) -> list[str]: """用轻量模型给每个句子打分,保留高分句子""" ...# 2. Token 级别压缩 — 去掉低信息量的 tokendef token_compression(text: str, query: str) -> str: """用压缩模型去掉冗余信息,保留关键内容""" ...# 3. 摘要式压缩 — 把长文本压缩为简短摘要def summarization(text: str, max_tokens: int = 500) -> str: """用 LLM 对检索到的上下文做摘要""" ...
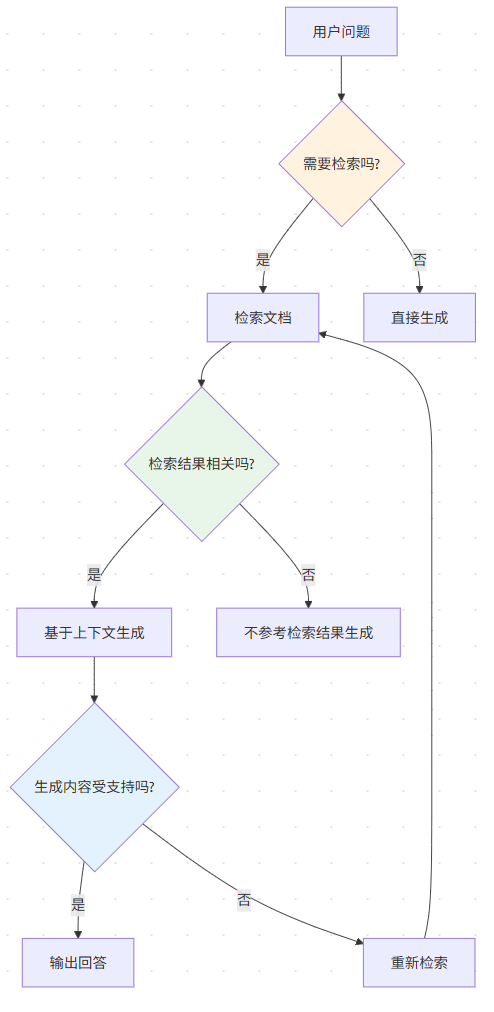
4. 多跳检索(Multi-hop Retrieval / Self-RAG)
当单次检索无法完整回答问题时,模型可以主动进行多轮检索:
用户: "GPT-4 相比 GPT-3.5 在哪些 benchmark 上有显著提升?"Step 1: 检索 "GPT-4 benchmark"→ 得到 MMLU、GSM8K 等数据Step 2: 模型判断信息不足,发起第二轮检索 "GPT-3.5 benchmark MMLU"→ 得到 GPT-3.5 的对比数据Step 3: 综合两轮检索结果生成回答
Self-RAG 框架(Asai et al., 2024):
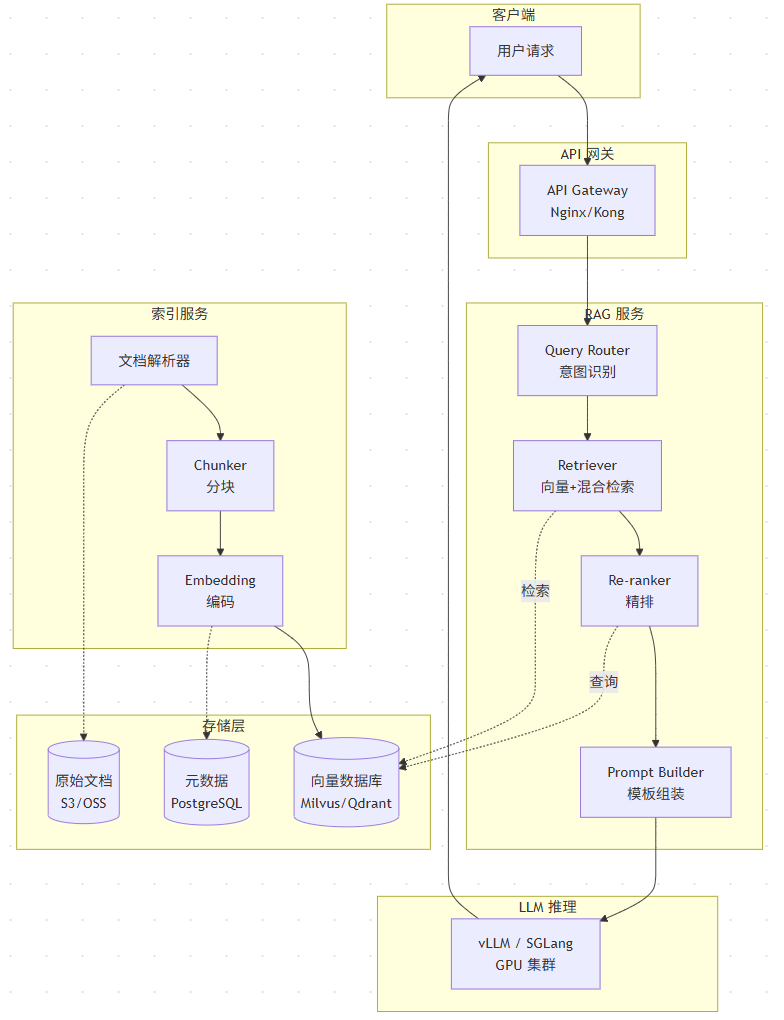
RAG 在生产环境中的架构
关键设计决策
性能指标
典型 RAG 请求的延迟分布:组件 | P50 | P95 | P99─────────────────|────────|────────|────────Embedding 编码 | 10ms | 25ms | 50ms向量检索 (Top-10)| 15ms | 40ms | 80msRe-ranker | 50ms | 120ms | 200msPrompt 组装 | 5ms | 10ms | 15msLLM 推理 | 800ms | 2000ms | 4000ms─────────────────|────────|────────|────────端到端 | 880ms | 2195ms | 4345msLLM 推理占端到端延迟的 90%+,是优化重点。
RAG 评估体系
核心指标(RAGAS 框架)
RAGAS (RAG Assessment) 四大指标:1. Faithfulness(忠实度) → 回答是否基于检索到的上下文?有无幻觉? → 测量:LLM 判断回答中的事实是否能在 context 中找到2. Answer Relevance(回答相关性) → 回答是否切题? → 测量:LLM 判断回答是否直接回应了用户问题3. Context Precision(上下文精确度) → 检索到的上下文中,有多少是真正有用的? → 测量:相关 chunk 数 / 总 chunk 数4. Context Recall(上下文召回率) → 是否检索到了回答所需的全部信息? → 测量:基于 ground truth 答案反推需要的事实是否都被检索到
评估 Pipeline
# 用 ragas 框架评估 RAG 系统from ragas import evaluatefrom ragas.metrics import faithfulness, answer_relevance, context_precision, context_recall# 测试数据集dataset = [ { "question": "GPT-4 的 MMLU 得分是多少?", "answer": "GPT-4 的 MMLU 得分为 86.4%", "contexts": ["根据 OpenAI 技术报告,GPT-4 在 MMLU 上得分为 86.4%"], "ground_truth": "86.4%" }, ...]results = evaluate(dataset, metrics=[ faithfulness, answer_relevance, context_precision, context_recall])print(results)# faithfulness: 0.92# answer_relevance: 0.88# context_precision: 0.85# context_recall: 0.78
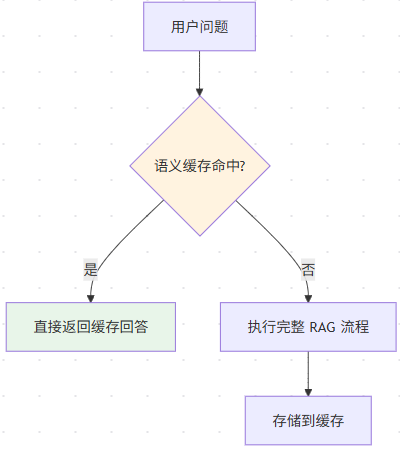
缓存策略
# 语义缓存示例from sentence_transformers import SentenceTransformerimport numpy as npmodel = SentenceTransformer("bge-large-zh-v1.5")# 缓存结构:[(embedding, answer, question), ...]cache = []def query_cache(question: str, threshold: float = 0.95) -> str | None: q_emb = model.encode(question) for cached_emb, cached_answer, cached_question in cache: sim = np.dot(q_emb, cached_emb) / (np.linalg.norm(q_emb) * np.linalg.norm(cached_emb)) if sim > threshold: return cached_answer return None
面试视角
常考问题
"RAG 是什么?为什么要用它?"
回答框架:
分阶段回答:
扩展阅读
 学习助手