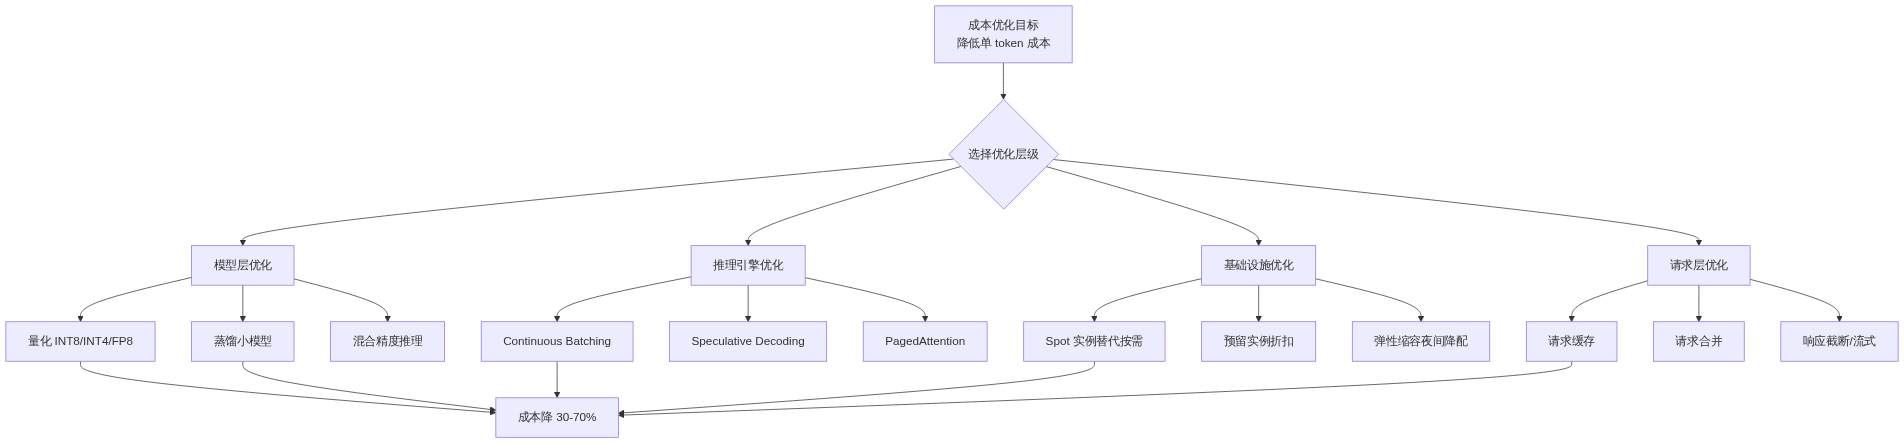
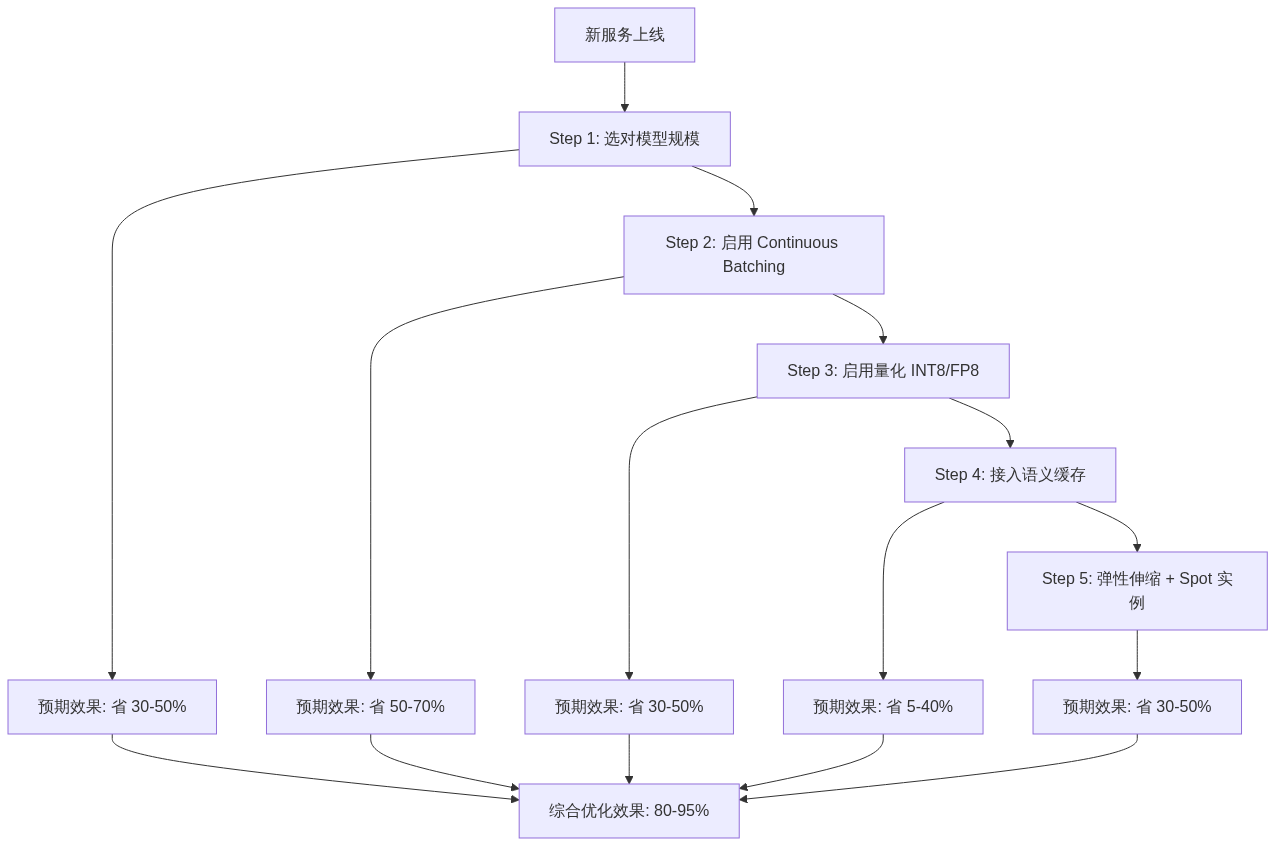
通过量化、批处理、弹性伸缩和模型选择,可将 LLM 推理成本降低 50-90%。
核心概念:分层优化框架
成本优化不是单一手段,而是多层联动的体系。
策略 1:量化降低成本
精度对比与成本节省
关键洞察:
量化方案对比
策略 2:批处理优化降低成本
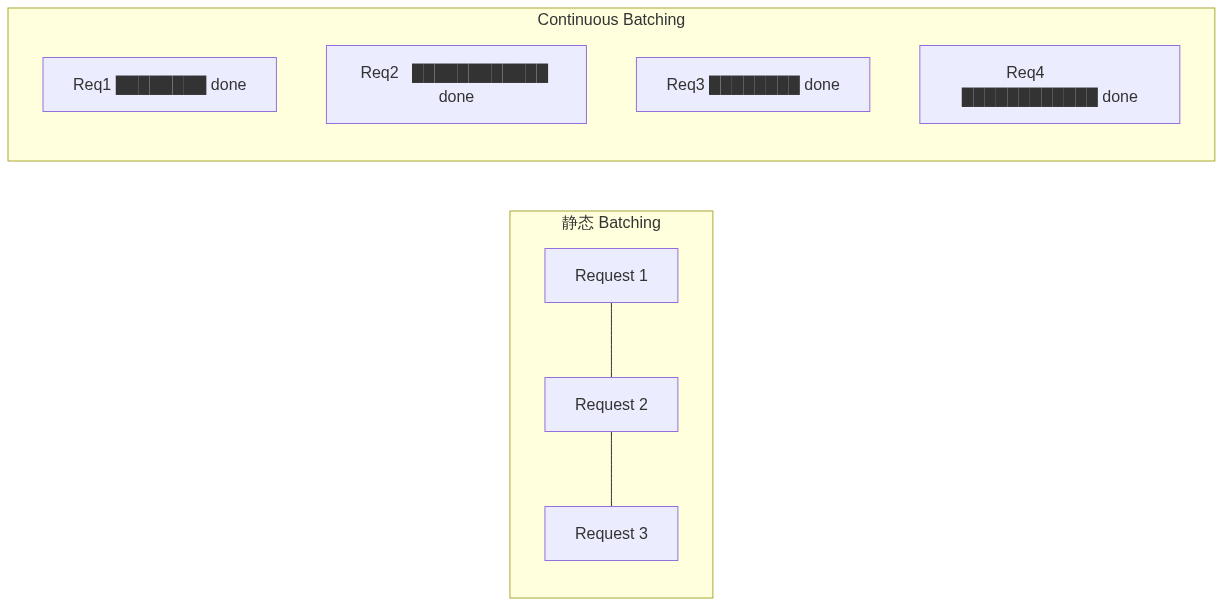
Continuous Batching 原理
传统的静态 batching 要求一个批次内所有请求同时到达、同时结束,导致 GPU 利用率低下。Continuous Batching(又称 Iteration-Level Batching)允许请求随时加入批次,单个请求完成后立即替换新请求。
效果量化:
Batch Size 调优
增大 batch size 提升吞吐(更多 token/s),但也会增加单个请求的排队延迟。需要在吞吐和延迟之间找到平衡点。
策略 3:弹性伸缩降低成本
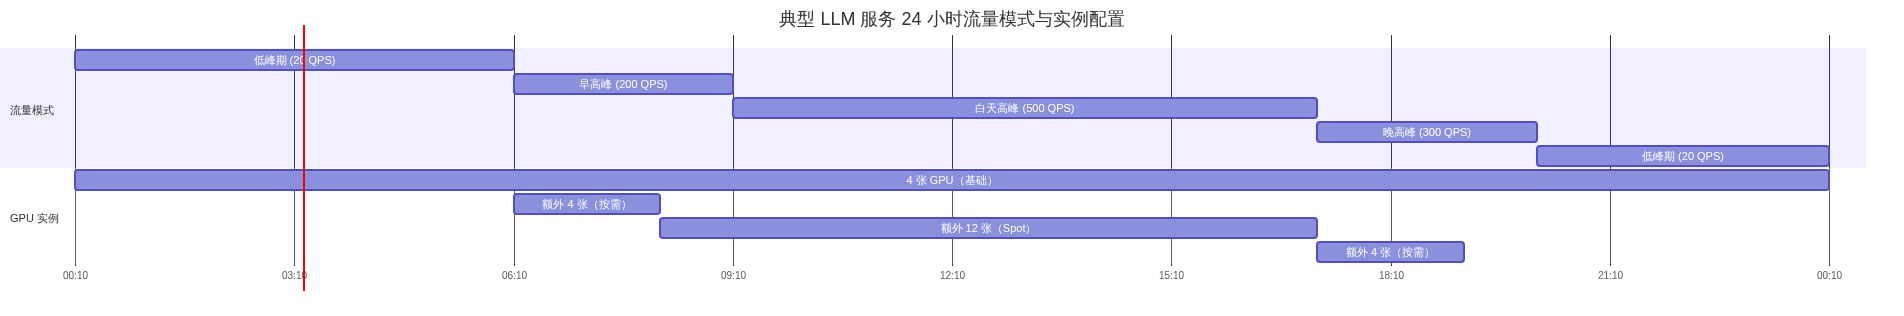
按时间模式伸缩
节省效果:
弹性策略建议
策略 4:模型选择降低成本
模型规模 vs 性价比分析
选择建议:
策略 5:请求合并和缓存
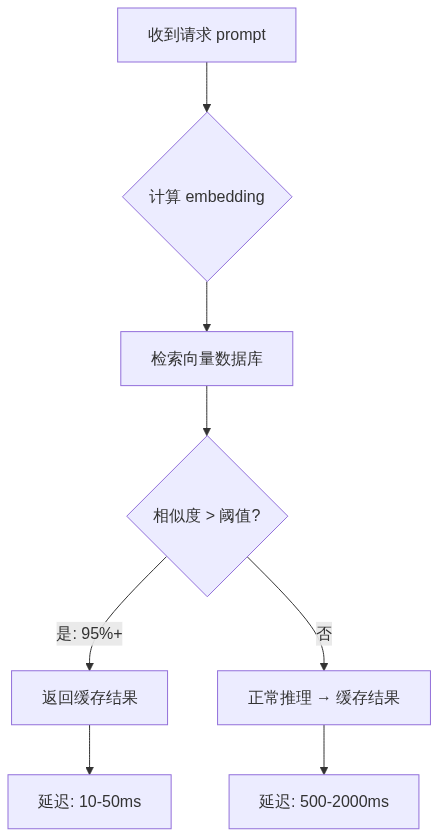
语义缓存(Semantic Caching)
对于重复或高度相似的 prompt,直接返回缓存结果,跳过推理。
Prompt 前缀缓存
部署视角
优化策略优先级
监控指标
面试视角
面试官可能问:
最佳实践
 学习助手