根据 QPS 预估、GPU 吞吐建模和 SLA 要求,精确计算需要多少 GPU 以及何时扩容。
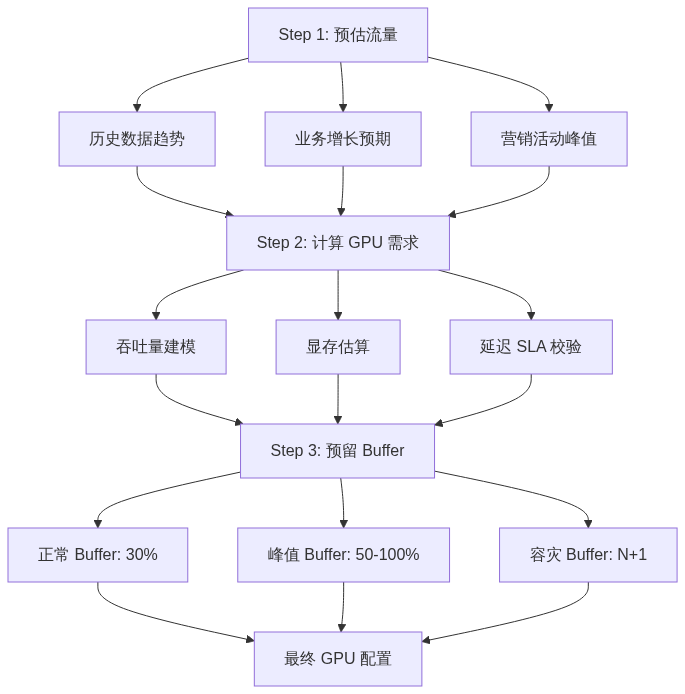
核心概念:容量规划三步法
Step 1:QPS 预估
流量建模
典型日流量曲线(SaaS 产品):
QPS
600 |         ████████
500 |    ██████████████
400 |   ████████████████
300 |  ██████████████████
200 | ████████████████████
100 |███                 ███
  0 +─────────────────────────
     00  04  08  12  16  20 (时)
关键指标:
Step 2:吞吐量建模
单 GPU 吞吐计算
单 GPU 总吞吐 = 理论峰值吞吐 × 利用率系数 × batch_size

其中:
  理论峰值吞吐:H100 FP16 decode ~1000 tokens/s(单请求)
  利用率系数:Continuous Batching 下 ~0.7-0.85
  batch_size:并发请求数(4-32,取决于模型大小)
不同模型规模的吞吐估算(H100 单卡):
注意:decode 阶段(逐 token 生成)是 compute-bound,prefill 阶段是 memory-bound。实际生产中以 decode 吞吐为主。
总吞吐计算
集群总吞吐 = 单卡吞吐 × GPU 数量 × 集群效率

集群效率:
  单卡部署:100%
  多卡 TP:90-95%(NCCL 通信开销 5-10%)
  多节点 TP:80-90%(跨节点通信开销 10-20%)
计算 GPU 数量
所需 GPU = ceil(峰值 QPS × 平均输出 tokens × decode 延迟 / 单 GPU 每秒 token 吞吐)
示例:峰值 600 QPS,平均 200 tokens 输出
70B 模型需要 220+ GPU,而 7B 只需 23 GPU → 模型选择是容量的第一决定因素。
Step 3:预留 Buffer
Buffer 类型
实例组合策略
总 GPU = 基础负载 (60%) + 弹性按需 (25%) + 弹性 Spot (15%)

示例:需要 100 GPU
  - 基础:60 张预留实例(月费打 4 折)
  - 弹性:25 张按需实例(随时启停)
  - Spot:15 张 Spot 实例(成本最低的弹性)
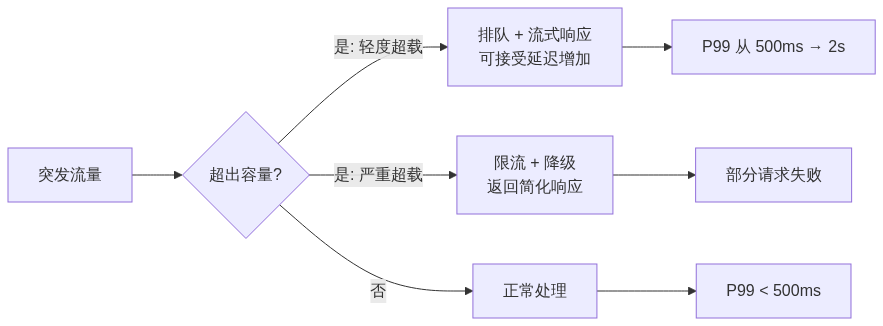
峰值流量处理
突发流量 vs 平均流量
应对策略矩阵
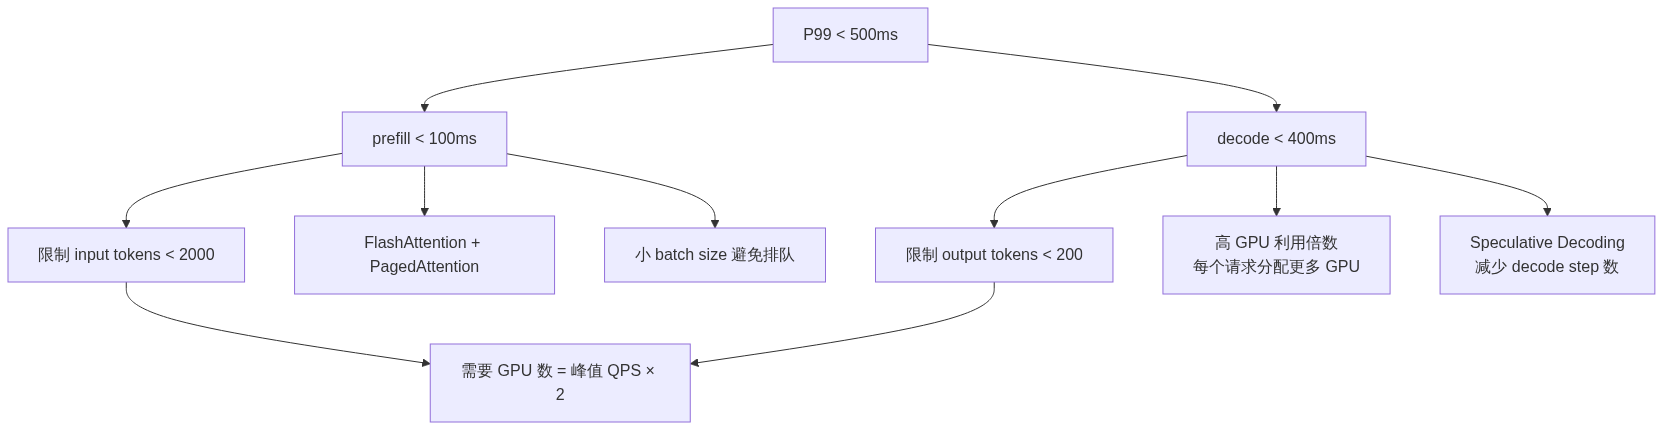
不同 SLA 要求下的容量规划
P99 < 500ms(严格 SLA)
P99 < 2s(宽松 SLA)
SLA 对比
部署视角
容量规划工具
自动扩缩容配置
# Kubernetes HPA 示例(基于自定义 metrics)apiVersion: autoscaling/v2kind: HorizontalPodAutoscalerspec: minReplicas: 4 maxReplicas: 20 metrics: - type: Pods pods: metric: name: gpu_utilization_percent target: type: Utilization averageUtilization: 70
面试视角
面试官可能问:
最佳实践
 学习助手