一句话概括核心:将 Transformer 的不同层分配到不同 GPU,通过 micro-batch 填充计算间隙,让多卡像流水线一样协同处理请求。
前置知识
核心概念
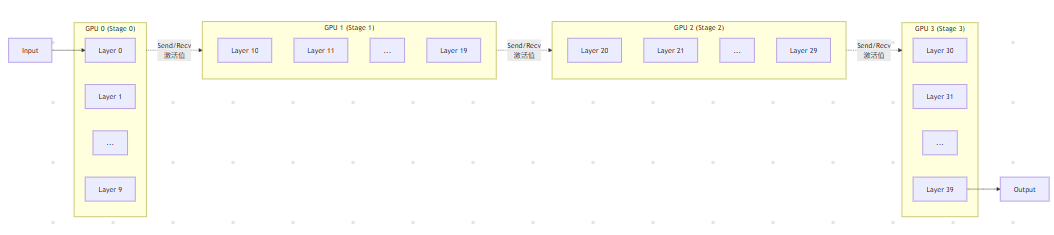
PP 分层放置原理
Pipeline Parallel 将模型的 Layer 维度切分,每张 GPU 负责连续的若干层。与 TP 按层内矩阵切分不同,PP 是按层间切分。
关键特性 :
为什么需要 Micro-Batch?
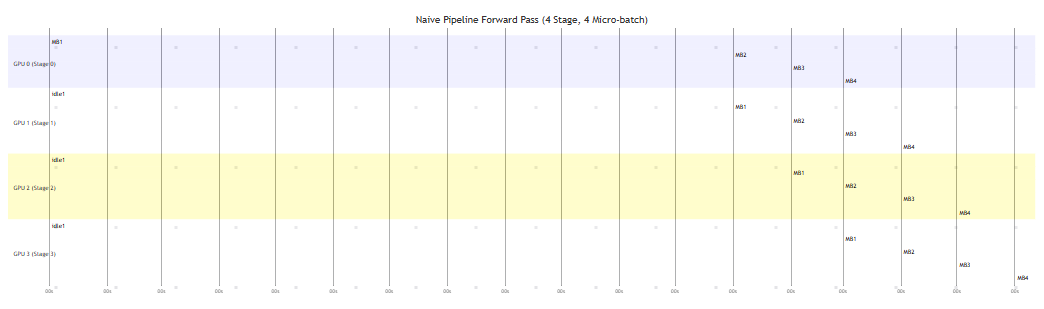
如果一次只处理一个请求(batch=1),GPU0 跑完 Layer 0-9 后传给 GPU1,GPU1 开始算 Layer 10-19,此时 GPU0 必须空闲等待 GPU1 完成才能处理下一个请求。这就是 Pipeline Bubble 。
引入 micro-batch 后:
Pipeline Bubble 详解
Naive Pipeline 的 Bubble 问题
Bubble 时间计算 :
P=4, M=4: bubble = 3/7 ≈ 43% P=4, M=16: bubble = 3/19 ≈ 16% P=8, M=8: bubble = 7/15 ≈ 47%
结论 :增大 micro-batch 数可以减少 bubble 比例,但会增加显存消耗。
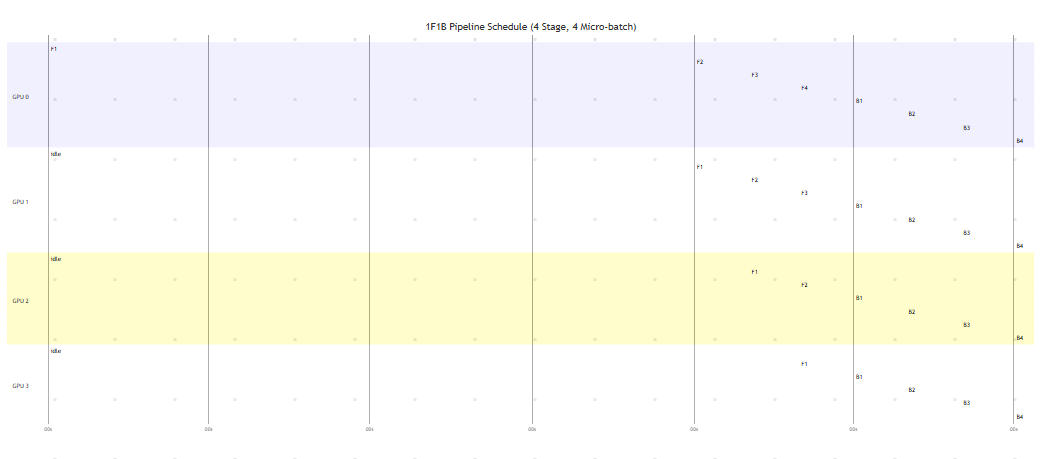
1F1B 调度(Interleaved Pipeline)
GPipe 和 PipeDream 提出的 1F1B(One Forward One Backward)调度显著减少了 bubble:
1F1B 的核心思想:
推理时的特殊性 :推理只有 forward pass(无 backward),所以 1F1B 的优化不直接适用。推理中常用的是 continuous batching + micro-batch 预热 来填充 bubble。
PP vs TP 对比
什么时候选 PP 而不是 TP?
选择 PP 的场景 :
选择 TP 的场景 :
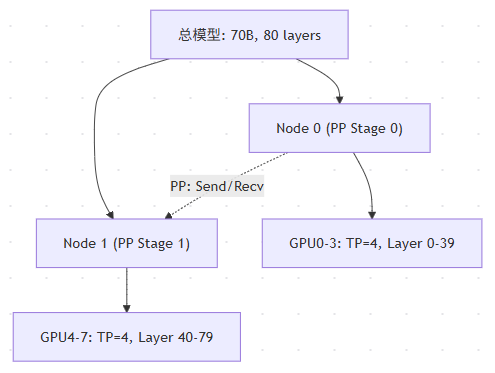
实际部署往往是组合 :
部署视角
vLLM 中的 PP
PP 部署注意事项
面试视角
Q1: Pipeline Bubble 是怎么产生的,怎么减少?
产生原因 :
减少方法 :
Q2: PP 和 TP 的本质区别是什么?
TP 是把一层矩阵计算拆开,要求同时执行、频繁同步(AllReduce),适合低延迟场景。
PP 是把不同层拆开,存在前后依赖,通过 micro-batch 提高并发度,适合超大模型。
一句话:TP 是"空间并行"(一起算),PP 是"时间并行"(流水线)。
Q3: 推理时 PP 的 bubble 怎么优化?
推理没有 backward pass,所以 1F1B 不直接适用。主要优化方法:
Q4: PP 通信会不会成为瓶颈?
通常不会。理由:
 学习助手